 Ekonomik SSD Hosting
 VDS Kirala
 Ryzen VDS
 Discord VDS
 Sunucu Barındırma
 Fiziksel Sunucu
 Rust Server Kirala
 Minecraft Server Kirala
 CS2 Server Kirala
 Unturned Server Kirala
 MTA Server Kirala
 FiveM Server Kirala
 Garry's Mod Server Kirala
 Palworld Server Kirala
 Valheim Server Kirala
 Layer 7 Koruma
 Rust Plugin Paket
Donanım Arızası mı, Siber Saldırı mı? Fiziksel Sunucu Arıza ve Güvenlik Tespiti
Fiziksel sunucunuz yavaşladı, kendiliğinden yeniden başladı ya da bağlantısı koptu. Sebep bir disk, bellek ya da güç kaynağı arızası mı, yanlış bir yapılandırma mı, yoksa yetkisiz erişim mi? Hangi kaydı nereden okuyacağınızı ve kanıtı bozmadan nasıl ilerleyeceğinizi adım adım anlatıyoruz.

İçindekiler
- Donanım arızası ile siber saldırı arasındaki fark nedir?
- Donanım arızasına işaret edebilecek belirtiler
- CPU sıcaklığı ve termal uyarılar
- Bellek hataları ve ECC kayıtları
- Disk SMART verileri ve I/O hataları
- Güç kaynağı, fan ve sensör uyarıları
- Beklenmeyen yeniden başlatmalar
- Siber saldırı veya yetkisiz erişim şüphesini artıran belirtiler
- Hangi loglar ve tanılama kayıtları incelenmeli?
- Zaman damgaları ve saat senkronizasyonu
- Kayıtları ilişkilendirmek
- Adım adım tanılama ve müdahale planı
- Kanıtı korumak neden bu kadar önemli?
- Hızlı karşılaştırma tablosu
- Ne zaman fiziksel sunucu müdahalesi, ne zaman olay müdahalesi gerekir?
- Sunucu arıza ve güvenlik kontrol listesi
- Sıkça sorulan sorular
- Sunucunun kendiliğinden yeniden başlaması saldırı anlamına gelir mi?
- Yüksek CPU kullanımı nasıl yorumlanmalı?
- Disk hatasıyla güvenlik ihlali aynı anda yaşanabilir mi?
- Donanım logları hangi bilgileri sağlar?
- Şüpheli bir olayda sunucuyu hemen yeniden başlatmak doğru mu?
- SMART durumu “PASSED” ise disk sağlam mıdır?
- Sonuç
- Kaynaklar
Sabah sunucunuzun gece iki kez yeniden başladığını fark ediyorsunuz. Ya da işlemci kullanımı hiçbir sebep yokken %100’e çıkmış, disk yanıt süreleri uzamış, uygulamanız zaman aşımı hataları veriyor. İlk akla gelen soru genellikle şu oluyor: Donanım mı bozuldu, yoksa biri sunucuya mı girdi?
Bu sorunun ilk belirtiye bakarak verilebilecek bir cevabı yok. Kendiliğinden yeniden başlama bir güç kaynağı arızasından da, bellek hatasından da, bir sürücü güncellemesinden de, yetkisiz bir müdahaleden de kaynaklanabilir. Yüksek CPU kullanımı yoğun trafiğin, hatalı bir zamanlanmış görevin ya da izinsiz kurulmuş bir kripto madencisinin sonucu olabilir. Bu yazı, fiziksel bir sunucuda (dedicated sunucu) karşılaştığınız belirtileri hangi kayıtlarla doğrulayacağınızı, kanıtı bozmadan nasıl ilerleyeceğinizi ve hangi noktada hangi uzmanı devreye almanız gerektiğini anlatıyor.
- Kural: Tek bir belirti teşhis değildir; yeniden başlama, yüksek CPU ya da disk yavaşlığı hem donanımdan hem saldırıdan kaynaklanabilir
- Önce: Belirtiyi, saatini ve etkisini kaydedin, planlı bakım olup olmadığını kontrol edin
- Kanıt: İhlal şüphesi varsa yeniden başlatmadan, silmeden ve yeniden kurmadan önce kayıtları koruyun
- Kaynaklar: IPMI/BMC olay günlüğü, SMART, ECC sayaçları, sistem ve kimlik doğrulama kayıtları
Donanım arızası ile siber saldırı arasındaki fark nedir?
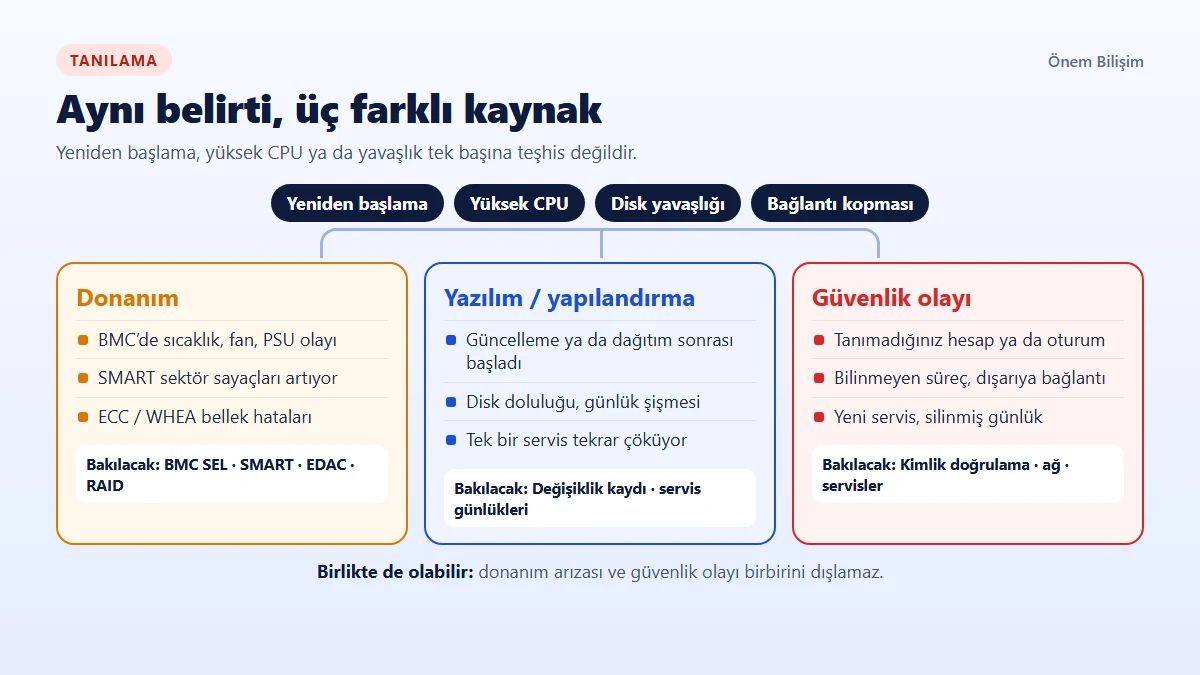
Bir sunucuda beklenmeyen davranışın arkasında genellikle dört olası kaynaktan biri ya da birkaçı vardır:
- Donanım arızası: Disk, bellek modülü, işlemci, güç kaynağı, fan, anakart ya da RAID denetleyicisi gibi fiziksel bir bileşenin bozulması ya da sınırlarının dışında çalışması. Aşırı ısınma da buraya girer.
- Yazılım sorunu: İşletim sistemi, sürücü, ürün yazılımı (firmware) ya da uygulamadaki bir hata. Örneğin bellek sızıntısı yapan bir servis veya hatalı bir güncelleme.
- Yanlış yapılandırma: Yanlış bir ayar, yetersiz kaynak sınırı, hatalı bir zamanlanmış görev ya da kapasite planlamasının gerisinde kalan bir sistem.
- Kötü niyetli faaliyet: Yetkisiz erişim, zararlı yazılım, izinsiz kripto madenciliği ya da sunucunun bir saldırıda kullanılması. Dışarıdan gelen bir DDoS saldırısı da bağlantı kesintisi olarak görünebilir.
Bu kategoriler birbirini dışlamaz. Bir saldırgan yükü artırdığı için zayıf bir fan ya da yıpranmış bir disk dayanamayabilir. Bir donanım arızası sırasında yapılan aceleci bir müdahale, güvenlik açığı bırakabilir. CISA, izinsiz kripto madenciliğinin sonuçları arasında performans düşüşünü, artan güç tüketimini, sistem çökmelerini ve bileşen arızasından kaynaklanan fiziksel hasarı birlikte sayıyor. Yani aynı olayda iki soru da “evet” cevabını alabilir.
Bu yüzden doğru yaklaşım, ilk belirtiye göre karar vermek değil, kayıtları toplayıp birbirleriyle karşılaştırmaktır.
Donanım arızasına işaret edebilecek belirtiler
Donanım sorunları çoğu zaman işletim sisteminin dışında da iz bırakır. Fiziksel sunucularda bulunan BMC (Baseboard Management Controller), işletim sisteminden bağımsız çalışan bir yönetim denetleyicisidir. Sensörleri izler ve olayları kendi günlüğüne yazar. Dell iDRAC, HPE iLO ve Supermicro IPMI arayüzleri bu denetleyicinin üretici sürümleridir. İşletim sistemi çökse bile bu kayıtlar çoğu zaman yerinde kalır.
CPU sıcaklığı ve termal uyarılar
İşlemci aşırı ısındığında önce frekansını düşürür (throttling), sınır aşılmaya devam ederse sistem kendini koruma amacıyla kapanabilir. Bunun dışarıdan görünen etkisi, “her şey yavaşladı” ya da “sunucu kendiliğinden kapandı” olur. BMC’nin sensör kayıtlarında ve olay günlüğünde sıcaklık eşiklerinin aşıldığını gösteren girdiler arayın. Linux’ta sensors komutu (lm-sensors) anlık değerleri gösterir.
Termal bir uyarı her zaman bozuk bir parça anlamına gelmez. Tıkanmış bir hava kanalı, durmuş bir fan ya da veri merkezindeki soğutma sorunu da aynı kaydı üretir. Öte yandan sürekli yüksek CPU yükü de sıcaklığı yükseltir. Bu yükün kaynağını ayrıca araştırmak gerekir.
Bellek hataları ve ECC kayıtları
Sunucu belleklerinin çoğu ECC (hata düzelten kod) kullanır. Linux çekirdeğinin RAS belgesi iki tür hatayı ayırır: düzeltilebilir hata (CE), algılanıp düzeltilen hatadır; düzeltilemeyen hata (UE) ise düzeltme eşiğini aşan ve sistemin kendiliğinden düzeltemediği hatadır. Aynı belgeye göre CE’ler gelecekteki UE’lerin habercisi olabilir ama olmak zorunda değildir. Düzenli CE üreten modüllerin önleyici olarak değiştirilmesi, UE ve sistem çökmesi olasılığını azaltır.
Linux’ta EDAC sayaçlarını şu şekilde okuyabilirsiniz:
grep . /sys/devices/system/edac/mc/mc*/ce_count /sys/devices/system/edac/mc/mc*/ue_count
ras-mc-ctl --errors
İkinci komut rasdaemon kuruluysa çalışır ve kaydedilmiş bellek hatalarını listeler. Windows tarafında donanım hataları Windows Hardware Error Architecture (WHEA) üzerinden raporlanır ve Sistem günlüğünde WHEA-Logger kaynağıyla görünür.
Disk SMART verileri ve I/O hataları
Diskler kendi sağlık verilerini SMART ile tutar. smartctl kılavuzuna göre -H seçeneği diskin genel sağlık durumunu gösterir. “Başarısız” durumu, diskin ya zaten bozulduğu ya da kendi arızasını 24 saat içinde öngördüğü anlamına gelir. Kılavuz bu durumda verilerinizi en kısa sürede güvenli bir yere almanızı önerir. NVMe disklerde sağlık durumu, SMART/Health Information günlüğündeki “Critical Warning” baytından okunur.
smartctl -H /dev/sda
smartctl -x /dev/sda
smartctl -a /dev/nvme0
Sağlık durumunun “PASSED” görünmesi diskin sağlam olduğunun garantisi değildir. Backblaze, 2016’daki analizinde arızayla en çok ilişkilendirdiği beş SMART değerini şöyle sıralıyor: 5 (yeniden atanan sektör sayısı), 187 (bildirilen düzeltilemeyen hatalar), 188 (komut zaman aşımı), 197 (bekleyen sektör sayısı) ve 198 (düzeltilemeyen sektör sayısı). Aynı analizde bozulan disklerin %23,3’ünün bu değerlerde hiçbir uyarı vermediği görülüyor. Bu değerlerin anlamı ve eşikleri üreticiden üreticiye değişebilir. Bu yüzden diskin üretici belgesine bakmak gerekir.
İşletim sistemi tarafında çekirdek günlüğündeki I/O hataları, zaman aşımları ve dosya sisteminin salt okunur moda geçmesi de disk ya da denetleyici sorununa işaret edebilir. Yazılım RAID kullanıyorsanız cat /proc/mdstat dizilerin durumunu gösterir. Donanım RAID’de denetleyicinin kendi aracını ve günlüğünü kullanın.
Güç kaynağı, fan ve sensör uyarıları
Yedekli güç kaynağı olan sunucularda bir PSU’nun devre dışı kalması sistemi durdurmayabilir ama BMC günlüğüne düşer. Fan devir hataları, voltaj eşiği uyarıları ve kasa açılma (chassis intrusion) sensörü de BMC’de kayıt bırakır. Kasa açılma kaydı, veri merkezinde planlı bir bakım yapılmadıysa hem donanım hem güvenlik açısından dikkat edilmesi gereken bir girdidir.
ipmitool sel elist
ipmitool sdr list
ipmitool sensor list
ipmitool kılavuzuna göre sel elist, Sistem Olay Günlüğü’nü (SEL) her olayı üreten sensörün adıyla birlikte gösterir. sensor list ise sensörleri eşik değerleriyle listeler. Hata kodlarının ve sensör adlarının anlamı modele göre değişir. Bir koda yorum yüklemeden önce sunucu üreticisinin belgesine bakın.
Beklenmeyen yeniden başlatmalar
Windows’ta beklenmeyen kapanma, bir sonraki açılışta Sistem günlüğüne Event ID 41 (Kernel-Power) olarak yazılır. Microsoft’un belgesine göre bu kayıt tek başına ne olduğunu açıklamaya yetmeyebilir. Kayıttaki BugcheckCode sıfırdan farklıysa sistem bir durdurma hatası (mavi ekran) yaşamıştır. Değer sıfırsa ve kayıt hiç oluşmadıysa, Microsoft bunun güç kaynağı sorununa ya da donanıma işaret edebileceğini yazıyor. Aynı belgeye göre 6008 önceki kapanmanın beklenmedik olduğunu, 1074 ise kapanmayı bir uygulamanın ya da kullanıcının başlattığını gösterir. 1074 kaydı, kapatmayı isteyen kullanıcı adını da içerir. Bu yüzden “kendiliğinden yeniden başladı” sanılan bir olayda kimin yeniden başlattığını gösterebilir.
Linux’ta bir önceki açılışın çekirdek mesajlarını görmek için kalıcı journal açık olmalıdır:
journalctl --list-boots
journalctl -k -p err -b -1
Siber saldırı veya yetkisiz erişim şüphesini artıran belirtiler
Aşağıdaki işaretler bir ihlali kanıtlamaz; araştırılması gereken soruları ortaya çıkarır. Meşru bakım çalışmaları, otomatik güncellemeler, yedekleme ve izleme ajanları da benzer kayıtlar üretebilir. Her işareti önce “Bunu biz mi yaptık?” sorusuyla değerlendirin.
- Tanımadığınız hesaplar ve yetki değişiklikleri: Yeni bir yönetici hesabı, sudo ya da Administrators grubuna eklenen bir kullanıcı, yeni bir SSH anahtarı. Windows’ta 4720 (kullanıcı hesabı oluşturuldu) ve 4732 (güvenlik etkin yerel gruba üye eklendi) olayları bu tür değişiklikleri kaydeder.
- Açıklanamayan oturumlar: Alışılmadık saatlerde, alışılmadık IP adreslerinden yapılan başarılı girişler ve hemen öncesinde çok sayıda başarısız deneme. Windows’ta 4624 başarılı, 4625 başarısız oturum açmayı kaydeder. Bu kayıtlar denetim (audit) ilkesi açıksa oluşur.
- Beklenmedik servisler ve zamanlanmış görevler: Kurmadığınız bir servis, yeni bir cron girdisi ya da systemd zamanlayıcısı. Windows’ta 7045 olayı, sisteme yeni bir servis kurulduğunu gösterir.
- Olağan dışı ağ bağlantıları: Sunucudan tanımadığınız adreslere sürekli giden bağlantılar, normalin çok üstünde giden trafik, sunucunun hiç kullanmadığı portlarda dinleme yapan süreçler.
- Değişmiş dosyalar: Sistem ikili dosyalarında, yapılandırma dosyalarında ya da web dizininde beklenmedik değişiklikler. Paket yöneticisinin doğrulama araçları (
rpm -Va,debsums -c) paketlerden gelen dosyalardaki değişiklikleri gösterebilir. - Günlüklerde boşluk ya da silinme: Belirli bir zaman aralığının kayıtlarının eksik olması ya da Windows’ta 1102 (denetim günlüğü temizlendi) kaydı. Saldırganlar izlerini silmeye çalışabilir; ama günlük dönüşümü (rotation) ve disk doluluğu da boşluk yaratabilir.
- Kaynak kullanımında açıklanamayan artış: CISA, izinsiz kripto madenciliği için “normalin üzerinde, sürekli CPU etkinliğini” ve işlem hızında belirgin düşüşü izlemenizi öneriyor.
Linux’ta ilk bakış için şu salt okunur komutlar kullanılabilir:
last -F | head -n 30
lastb | head -n 30
getent group sudo wheel
ss -tunap
systemctl list-units --type=service --state=running
systemctl list-timers --all
ls -la /etc/cron.d /var/spool/cron
Önemli bir uyarı: Sunucu gerçekten ele geçirildiyse, üzerindeki programlar da değiştirilmiş olabilir. Kanıt toplama üzerine yazılmış RFC 3227 açıkça “sistemdeki programlara güvenmeyin” der ve kanıt toplama araçlarının korunmuş bir ortamdan çalıştırılmasını önerir. Bu komutlar ilk izlenim için faydalıdır, ama ciddi bir şüphede tek başına güvenilir kanıt sayılmaz.
Hangi loglar ve tanılama kayıtları incelenmeli?
Her kayıt kaynağı sorunun farklı bir katmanını gösterir. Teşhiste asıl değer, bu katmanları aynı zaman çizelgesine yerleştirmekten gelir.

| Kayıt kaynağı | Nerede | Ne gösterir | Dikkat edilecek nokta |
|---|---|---|---|
| BMC olay günlüğü (SEL) | iDRAC, iLO, IPMI arayüzü ya da ipmitool sel elist | Sıcaklık, fan, voltaj, güç kaynağı, bellek ve kasa olayları | İşletim sisteminden bağımsızdır; kodların anlamı üreticiye göre değişir |
| Çekirdek ve donanım hataları | Linux: journalctl -k, EDAC sayaçları. Windows: WHEA-Logger | Bellek (CE/UE), işlemci (MCE), PCIe ve sürücü hataları | Önceki açılışı görmek için kalıcı günlük gerekir |
| Disk ve RAID | smartctl, /proc/mdstat, RAID denetleyici aracı | Sektör hataları, zaman aşımları, bozulan ya da yeniden kurulan diziler | “PASSED” durumu sağlamlık garantisi değildir |
| İşletim sistemi olayları | Linux: journal ve /var/log. Windows: Sistem ve Uygulama günlükleri | Servis çökmeleri, yeniden başlatmalar (41, 6008, 1074), güncellemeler | Planlı işlemleri bakım kayıtlarıyla eşleştirin |
| Kimlik doğrulama | Linux: auth.log ya da secure, last, lastb. Windows: Güvenlik günlüğü | Oturumlar, başarısız denemeler, hesap ve grup değişiklikleri | Windows’ta denetim ilkesi açık değilse kayıt oluşmaz |
| Ağ ve güvenlik duvarı | Güvenlik duvarı, yönlendirici, DDoS koruma ve akış kayıtları | Trafik artışları, alışılmadık hedefler, engellenen bağlantılar | Bu kayıtlar çoğu zaman sağlayıcının ya da ağ ekibinin elindedir |
Zaman damgaları ve saat senkronizasyonu
Kayıtları ilişkilendirmenin ön şartı, saatlerin doğru ve tutarlı olmasıdır. BMC’nin saati, işletim sisteminin saati ve ağ cihazlarının saati birbirinden farklıysa “disk hatası saldırıdan önce mi sonra mı?” sorusunu yanıtlayamazsınız. Microsoft, Event ID 41 belgesinde de olay dosyalarındaki saatin sistem saatine göre ayarlandığını ve sunucunun saat dilimini kontrol etmek gerektiğini hatırlatıyor. Linux’ta timedatectl ve chronyc tracking, saatin senkron olup olmadığını gösterir. BMC’nin saatini de NTP’ye bağlamak ya da en azından farkı not etmek, sonraki analizleri kolaylaştırır.
Kayıtları ilişkilendirmek
Pratikte şöyle bir zaman çizelgesi işinizi görür: Belirtinin başladığı saatin 30–60 dakika öncesinden itibaren her kaynaktaki kayıtları tek bir tabloya dökün. Örneğin 02:14’te BMC’de bir güç kaynağı uyarısı, 02:15’te Kernel-Power 41 ve öncesinde hiçbir oturum kaydı yoksa güç tarafı öne çıkar. Ama 01:50’de tanımadığınız bir IP’den başarılı bir SSH oturumu, 01:52’de yeni bir servis ve 02:00’den itibaren %100 CPU görüyorsanız tablo farklı bir hikâye anlatır.
Adım adım tanılama ve müdahale planı
Bu plan, hem donanım arızasında hem güvenlik olayında işe yarayacak şekilde sıralandı. Her adımda üç soruyu aklınızda tutun: Bu işlem hizmeti ne kadar keser? Veri kaybı riski var mı? Bir ihlal ihtimali varsa kanıtı bozar mı?

- Belirtiyi, başlama zamanını ve etki alanını kaydedin. Ne oldu, ilk ne zaman fark edildi, hangi servisler etkilendi? Ekran görüntüsü alın, hata mesajlarını aynen kopyalayın.
- Planlı bir değişiklik olup olmadığını kontrol edin. Güncelleme, bakım, yapılandırma değişikliği, yeni bir dağıtım ya da veri merkezindeki bir çalışma var mıydı? Pek çok “gizemli” olayın cevabı burada çıkar.
- Fiziksel sağlığı inceleyin. BMC olay günlüğü, sensörler, SMART, ECC sayaçları ve RAID durumu. Bu adım çoğunlukla salt okunurdur ve sunucuyu durdurmayı gerektirmez.
- İşletim sistemi, ağ ve kimlik doğrulama kayıtlarını değerlendirin. Çökme ve yeniden başlatma kayıtları, servis hataları, oturumlar ve ağ bağlantıları.
- Son değişiklikleri ve yetkisiz erişim işaretlerini araştırın. Yeni hesaplar, yetki değişiklikleri, yeni servisler ve zamanlanmış görevler, değişmiş dosyalar.
- İki ihtimali birlikte değerlendirin. Bir donanım bulgusu, güvenlik bulgusunu ortadan kaldırmaz; tersi de geçerlidir. Zaman çizelgesine bakarak hangisinin önce geldiğini ve birbirini tetikleyip tetiklemediğini sorun.
- Kontrollü bir müdahale planı hazırlayın. Hizmet sürekliliği, yedeklerin durumu ve olası zarar birlikte tartılmalı. Arızalı bir disk değiştirilecekse önce yedeğin geri yüklenebilir olduğunu doğrulayın.
- Kritik bir ihlal şüphesinde kanıtı koruyun ve olay müdahale ekibini devreye alın. ABD (CISA), Avustralya, Kanada, Yeni Zelanda ve Birleşik Krallık siber güvenlik kurumlarının ortak rehberi (AA20-245A), etkilenen sistemi kanıt korunmadan düzeltmeyi, kimlik bilgilerini erken sıfırlamayı ve günlükleri toplamamayı en sık yapılan hatalar arasında sayıyor. Bu hatalar uçucu verileri yok edebilir ve saldırganı uyarabilir.
- Onarımdan sonra kontrolleri tekrarlayın. Parça değişiminden ya da yazılım düzeltmesinden sonra sağlık kontrollerini yeniden çalıştırın, güvenlik açısından da hesapları, servisleri ve ağ bağlantılarını tekrar gözden geçirin. Belirtinin geri gelip gelmediğini birkaç gün izleyin.
Kanıtı korumak neden bu kadar önemli?
Kanıt toplama üzerine yazılmış RFC 3227, verileri uçuculuk sırasına göre toplamayı önerir: önce yazmaçlar ve önbellek, sonra yönlendirme tablosu, ARP önbelleği, süreç tablosu, çekirdek istatistikleri ve bellek, ardından geçici dosya sistemleri ve disk. Aynı belge “kanıt toplamayı tamamlamadan sistemi kapatmayın” der. Sunucuyu yeniden başlatmak, bellekteki süreçleri, açık ağ bağlantılarını ve geçici dosyaları siler. Saldırganın değiştirdiği kapanış betikleri de kanıtı yok edebilir.
Bu, hiçbir durumda sunucuyu kapatmamanız gerektiği anlamına gelmez. Aktif bir veri sızıntısı ya da yayılan bir zararlı varsa ağ bağlantısını kesmek gerekebilir. Bu kararı mümkünse olay müdahale ekibiyle birlikte verin ve ne yaptığınızı saatiyle not edin.
Hızlı karşılaştırma tablosu
Aşağıdaki tablo, aynı belirtinin farklı kaynaklarda nasıl görünebileceğini özetliyor. Bu tablo otomatik bir teşhis aracı değildir. Yalnızca hangi kayda önce bakacağınıza karar vermenize yardım eder.
| Belirti | Donanım kaynaklıysa genellikle | Yazılım veya yapılandırma kaynaklıysa | Güvenlik olayıysa | İlk doğrulama |
|---|---|---|---|---|
| Kendiliğinden yeniden başlama | BMC’de güç, sıcaklık ya da bellek olayı; Event 41’de BugcheckCode 0 | Sürücü ya da güncelleme sonrası durdurma hatası, otomatik yeniden başlatma | Öncesinde açıklanamayan oturum; 1074’te tanımadığınız kullanıcı | BMC SEL, Event 41/6008/1074, journalctl -b -1 |
| Sürekli yüksek CPU | Termal kısıtlama nedeniyle düşük frekans | Döngüye giren süreç, hatalı cron görevi, yoğun trafik | Tanımadığınız bir süreç, dışarıya sürekli bağlantı | Süreç listesi, sensörler, ss -tunap |
| Disk yavaşlığı ve I/O hataları | SMART 5/187/188/197/198 artışı, RAID dizisinde bozulma | Disk doluluğu, günlük şişmesi, yanlış I/O zamanlayıcısı | Toplu şifreleme ya da beklenmedik yoğun yazma | smartctl, /proc/mdstat, disk doluluğu |
| Bağlantı kopmaları | Ağ kartı ya da kablo hatası, bağlantı noktası kapanıp açılıyor | Yanlış güvenlik duvarı kuralı, IP çakışması | DDoS, sunucudan dışarıya anormal trafik | Ağ arayüzü sayaçları, güvenlik duvarı ve sağlayıcı kayıtları |
| Servis çökmeleri | ECC hataları sonrası rastgele çökmeler | Bellek sızıntısı, hatalı sürüm, kaynak sınırı | Değiştirilmiş ikili dosya ya da yapılandırma | Servis günlükleri, EDAC/WHEA, paket doğrulaması |
| Yeni hesap ya da yetki değişikliği | İlgisiz | Yeni kurulan bir yazılımın hesabı | Yetkisiz hesap ya da yetki yükseltme | 4720/4732, getent group, değişiklik kaydı |
Sunucunuzda gözlemlediğiniz işaretleri seçin. Araç teşhis koymaz; hangi kayıtlardan başlamanın mantıklı olduğunu sıralar.
Bu bir yönlendirme aracıdır, otomatik teşhis aracı değildir. Aynı belirti birden fazla kaynaktan gelebilir. Araç tarayıcınızda çalışır, veri göndermez.
Ne zaman fiziksel sunucu müdahalesi, ne zaman olay müdahalesi gerekir?
Donanım üreticisine ya da veri merkezi ekibine başvurun: BMC’de tekrar eden bellek, güç kaynağı ya da sıcaklık olayları; SMART’ta artan yeniden atanan veya bekleyen sektörler; bozulan bir RAID dizisi; düzeltilemeyen bellek hataları; fiziksel bir bileşenin sesi, ışığı ya da durumu. Bu durumlarda parça değişimi, ürün yazılımı güncellemesi ve fiziksel kontrol gerekir. Kiralık bir fiziksel sunucu kullanıyorsanız bulguları sağlayıcınızın destek ekibiyle paylaşın. Önem Bilişim’in fiziksel sunucu kiralama paketlerinde sunucular Datacasa İstanbul’da çalışır ve 7/24 teknik destek sunulur. Kendi sunucunuzu veri merkezinde barındırıyorsanız 7/24 KVM erişimi, uzaktan ve fiziksel destek içeren sunucu barındırma hizmeti, işletim sistemine ağ üzerinden ulaşamadığınız durumlarda da konsoldan müdahaleyi kolaylaştırır.
Güvenlik uzmanlarını ya da olay müdahale ekibini devreye alın: Tanımadığınız yönetici hesapları, açıklanamayan başarılı oturumlar, silinmiş günlükler, değiştirilmiş sistem dosyaları, dışarıya veri çıkışını düşündüren trafik ya da bir fidye notu. Kişisel veri işleyen bir işletmeyseniz şunu da bilin: KVKK Kurulu’nun 2019/10 sayılı kararı, kişisel veri ihlalinin öğrenildiği andan itibaren gecikmeksizin ve en geç 72 saat içinde Kurul’a bildirilmesini öngörüyor. Bu bir hukuki tavsiye değildir; durumunuzu hukuk danışmanınızla değerlendirin.
İki ekibin birlikte çalışması gereken durumlar: Bir diskin bozulduğu ama aynı dönemde şüpheli oturumların da görüldüğü, aşırı ısınmanın kaynağının bilinmeyen bir süreç olduğu ya da BMC’nin kendisinin şüpheli olduğu durumlar. BMC, işletim sistemini atlayarak sunucuyu yeniden başlatabilen, işletim sistemi kurabilen güçlü bir arayüzdür. CISA, IPMI arayüzlerinin internete açık bırakılmamasını, yalnızca güvenilir iç ağlara ve yönetim VLAN’ına sınırlanmasını, güçlü ve benzersiz parolalar kullanılmasını, şifrelemenin açılmasını ve anonim girişin kapatılmasını öneriyor. Donanım ekibinin parça değiştirmesi, güvenlik ekibinin kanıtı korumasıyla çakışmamalı. Örneğin bir disk sökülmeden önce imajının alınıp alınmayacağına birlikte karar verilmeli.
Veri merkezi tarafındaki enerji ve soğutma altyapısı da arızaların bir parçası olabilir. Yedekli enerji ve hat konusunu yedekli enerji ve hat hızı yazımızda, kiralık sunucu ile kendi sunucunu barındırma arasındaki sorumluluk farkını da colocation mı dedicated sunucu mu yazımızda anlattık.
Sunucu arıza ve güvenlik kontrol listesi
Aşağıdaki listeyi bir olay sırasında sırayla işaretleyebilirsiniz. Her madde her sunucu için geçerli olmayabilir; size uymayanları atlayın.
Olay sırasında tamamladığınız adımları işaretleyin.
Liste tarayıcınızda çalışır, hiçbir veri gönderilmez. Sayfayı yenilediğinizde işaretler sıfırlanır.
Sıkça sorulan sorular
Sunucunun kendiliğinden yeniden başlaması saldırı anlamına gelir mi?
Tek başına gelmez. Microsoft’un Event ID 41 belgesi, beklenmeyen kapanmaların çoğunlukla işletim sistemi dışındaki bileşenlerden kaynaklandığını yazıyor ve güç kaynağını, belleği ve aşırı ısınmayı kontrol etmeyi öneriyor. Windows’ta 1074 kaydı kapanmayı kimin başlattığını, BMC günlüğü ise donanım olaylarını gösterir. Öncesinde açıklanamayan oturumlar ya da yetki değişiklikleri varsa güvenlik tarafını da araştırın.
Yüksek CPU kullanımı nasıl yorumlanmalı?
Önce hangi sürecin CPU kullandığına ve bunun beklenen bir iş yükü olup olmadığına bakın. Yoğun trafik, yedekleme ya da hatalı bir zamanlanmış görev de yüksek CPU üretir. Tanımadığınız bir süreç, dışarıya sürekli bağlantı ve açıklanamayan sürekli yük birlikteyse CISA’nın izinsiz kripto madenciliği uyarısında tarif ettiği tabloya benzeyebilir; bu durumda güvenlik incelemesi yapın.
Disk hatasıyla güvenlik ihlali aynı anda yaşanabilir mi?
Evet. Donanım arızası ve güvenlik olayı birbirini dışlamaz. Bir saldırganın yarattığı yoğun yazma yükü yıpranmış bir diski hızlandırabilir. Bir disk değişimi sırasında yapılan aceleci işlemler de kanıtı yok edebilir. Zaman çizelgesi kurarak iki olayın sırasını ve ilişkisini değerlendirin.
Donanım logları hangi bilgileri sağlar?
BMC olay günlüğü sıcaklık, fan, voltaj, güç kaynağı, bellek ve kasa olaylarını, işletim sisteminden bağımsız olarak kaydeder. SMART disklerin sektör ve hata sayaçlarını, ECC sayaçları ise düzeltilen ve düzeltilemeyen bellek hatalarını gösterir. Hata kodlarının anlamı üreticiye ve modele göre değiştiği için yorumlamadan önce üretici belgesine bakın.
Şüpheli bir olayda sunucuyu hemen yeniden başlatmak doğru mu?
Bir ihlal şüphesi varsa genellikle hayır. Yeniden başlatma bellekteki süreçleri, açık bağlantıları ve geçici dosyaları siler. RFC 3227, kanıt toplama tamamlanmadan sistemin kapatılmamasını öneriyor. Aktif bir veri sızıntısı ya da yayılan bir zararlı varsa ağ bağlantısını kesmek gibi bir kontrol adımı gerekebilir. Bu kararı mümkünse olay müdahale ekibiyle birlikte verin.
SMART durumu “PASSED” ise disk sağlam mıdır?
Her zaman değil. Backblaze’in 2016 analizinde bozulan disklerin %23,3’ü izlenen SMART değerlerinde hiçbir uyarı vermemişti. Genel durumla birlikte yeniden atanan, bekleyen ve düzeltilemeyen sektör sayaçlarını, disk hata günlüğünü ve işletim sistemindeki I/O hatalarını birlikte değerlendirin.
Sonuç
Fiziksel bir sunucuda beklenmeyen bir davranış gördüğünüzde en büyük risk, sebebi bilmeden müdahale etmektir. Donanım arızası sandığınız bir olayda sunucuyu yeniden kurmak bir saldırının izlerini silebilir. Saldırı sandığınız bir olayda ise asıl sorun olan bozulan diski gözden kaçırabilirsiniz.
Doğru yöntem her iki ihtimal için de aynıdır: belirtiyi ve saati kaydedin, planlı değişiklikleri eleyin, BMC’den kimlik doğrulama kayıtlarına kadar tüm katmanları aynı zaman çizelgesine yerleştirin, kayıtları koruyun ve bulgulara göre doğru ekibi devreye alın. Donanım ekibi ile güvenlik ekibi aynı tablodan çalıştığında hem arıza daha hızlı giderilir hem de olası bir ihlalin kanıtı korunur.
Fiziksel sunucu
Donanımı 7/24 izlenen bir veri merkezinde çalıştırın
Datacasa İstanbul’da Intel Xeon ve AMD Ryzen fiziksel sunucular; ücretsiz kurulum, StormWall ve Mikrotik DDoS koruması ve 7/24 teknik destek.
Kaynaklar
- Microsoft — Event ID 41: The system has rebooted without cleanly shutting down first
- Microsoft — Windows Hardware Error Architecture (WHEA)
- Microsoft — 4720(S): A user account was created
- Linux çekirdeği — Reliability, Availability and Serviceability (RAS) ve EDAC
- smartctl(8) kılavuz sayfası
- Backblaze — What SMART Stats Tell Us About Hard Drives (Ekim 2016)
- ipmitool(1) kılavuz sayfası
- CISA — Risks of Using the Intelligent Platform Management Interface (IPMI)
- CISA ve ortakları — AA20-245A: Technical Approaches to Uncovering and Remediating Malicious Activity
- CISA — Defending Against Illicit Cryptocurrency Mining Activity
- RFC 3227 — Guidelines for Evidence Collection and Archiving
- NIST SP 800-61 Rev. 3 — Incident Response Recommendations and Considerations (Nisan 2025)
- NIST SP 800-86 — Guide to Integrating Forensic Techniques into Incident Response