 Ekonomik SSD Hosting
 VDS Kirala
 Ryzen VDS
 Discord VDS
 Sunucu Barındırma
 Fiziksel Sunucu
 Rust Server Kirala
 Minecraft Server Kirala
 CS2 Server Kirala
 Unturned Server Kirala
 MTA Server Kirala
 FiveM Server Kirala
 Garry's Mod Server Kirala
 Palworld Server Kirala
 Valheim Server Kirala
 Layer 7 Koruma
 Rust Plugin Paket
 Yazılım Hizmetleri
Kendi Özel Yapay Zeka Modelinizi Eğitin: LLaMA 3 ve DeepSeek İnce Ayarı (Fine-Tuning) İçin Donanım Rehberi
LoRA, QLoRA ve tam ince ayarın VRAM ihtiyacı, Llama ve DeepSeek modellerinin hangi boyutlarının tek sunucuya sığdığı, RAM ve NVMe ilişkisi ve Hugging Face PEFT ile kurulum tek yazıda.
İçindekiler
- LLM Fine Tuning Donanım Gereksinimleri Neye Bağlıdır?
- LoRA Nedir, QLoRA ve Tam İnce Ayardan Farkı Ne?
- Fine Tuning İçin Kaç GB VRAM Gerekir?
- Kendi modeliniz için hesabı nasıl yaparsınız?
- Eğitim süresini nasıl tahmin edersiniz?
- Çoklu GPU belleği gerçekten toplar mı?
- Llama ve DeepSeek Modellerinin Hangi Sürümleri Tek Sunucuya Sığar?
- RAM ve NVMe Eğitim Hızını Nasıl Etkiler?
- Hugging Face PEFT ile QLoRA Eğitimi Nasıl Kurulur?
- GPU VDS Bu Sürecin Neresinde Kullanılır?
- Hangi Yapılandırma Hangi Modele Uyar?
- Sık Sorulan Sorular
- İnce ayar için ne kadar veri gerekir?
- Fine tuning mı RAG mı kullanmalıyım?
- LoRA adaptörü ne kadar yer kaplar?
- İnce ayarlı modeli küçük bir sunucuda çalıştırabilir miyim?
- Eğitilen modelin ticari kullanımı serbest mi?
- Eğitim yarıda kesilirse çalışmam kaybolur mu?
- Sonuç: LLM Fine Tuning Donanım Gereksinimleri İçin Karar
Kendi verinizle bir dil modeli eğitmek istediğinizde ilk engel çoğu zaman algoritma değil, belleğin yetmemesidir. Yanlış yöntemi seçerseniz 8 milyar parametreli bir model bile kartın sınırını aşar. LLM fine tuning donanım gereksinimleri, modelin büyüklüğü kadar seçtiğiniz ince ayar yöntemine de bağlıdır. Burada LoRA, QLoRA ve tam ince ayarın bellek ihtiyacını hesaplayacak, sonucu GPU fiziksel sunucu kiralama seçeneklerindeki 24, 48 ve 80 GB üzeri yapılandırmalarla eşleştireceksiniz.
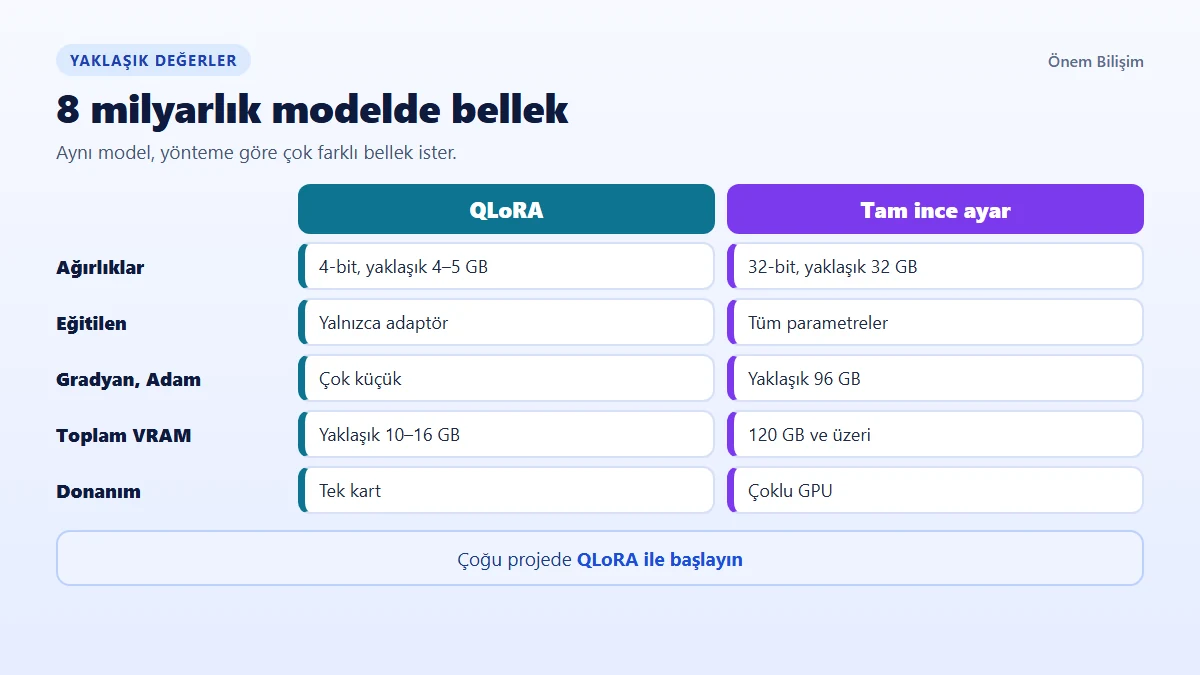
Kısa Cevap: LLM ince ayarında VRAM ihtiyacını yöntem belirler. 7–8 milyar parametreli modelleri QLoRA ile yaklaşık 10–16 GB, 70 milyarlıkları 48 GB civarında eğitebilirsiniz; 80 GB rahat çalışma alanı verir. Tam ince ayar ise 8 milyarlık modelde bile 120 GB’ı aşar ve çoklu GPU gerektirir.
LLM Fine Tuning Donanım Gereksinimleri Neye Bağlıdır?
LLM fine tuning donanım gereksinimleri dört değişkene bağlıdır: Parametre sayısı, ağırlıkların hassasiyeti, eğitilen parametre oranı ve batch ile dizi uzunluğu. İlk ikisi modelin bellekte kapladığı sabit yeri belirler. Son ikisi ise eğitim sırasında oluşan gradyanların ve ara hesapların yükünü belirler.
Temel hesap parametre başına bayt üzerinden yapılır. 16-bit (FP16) bir ağırlık 2 bayt, 4-bit nicemlenmiş bir ağırlık yaklaşık 0,5–0,6 bayt tutar. Dolayısıyla 8 milyar parametreli bir modelin ağırlıkları FP16’da yaklaşık 16 GB, 4-bit’te yaklaşık 4–5 GB yer kaplar.
Çıkarım (inference) ile eğitim arasındaki fark burada başlar. Çıkarımda ağırlıklara yalnızca üretim sırasındaki KV önbelleği eklenir. Eğitimde ise eğitilen her parametre için gradyan, optimizasyon durumu ve katman çıktıları da bellekte tutulur.
Bu yüzden “modeli çalıştırabiliyorum, o hâlde eğitebilirim” varsayımı çoğu projede yanlış çıkar. Kart seçerken dikkat edilecek diğer ölçütleri GPU kiralama kontrol listesinde topladık. İnce ayara başlamadan önce önce yöntemi seçin, kartı yönteme göre belirleyin.
LoRA Nedir, QLoRA ve Tam İnce Ayardan Farkı Ne?
LoRA, modelin ağırlıklarını dondurup yalnızca araya eklenen küçük ve düşük dereceli matrisleri eğiten bir yöntemdir. Eğitilen parametre sayısı toplamın küçük bir bölümüne indiği için gradyan ve optimizasyon belleği de aynı oranda küçülür. Hugging Face PEFT kütüphanesi bu yöntemin yaygın uygulamasıdır.
QLoRA aynı fikri 4-bit nicemlenmiş bir taban modele uygular. Taban modelin kapladığı yer yaklaşık dörtte birine indiği için çok daha büyük modeller tek karta sığar. QLoRA makalesi bu yöntemle 65 milyar parametreli bir modelin tek bir 48 GB GPU üzerinde ince ayarının yapılabildiğini gösterir.
Tam ince ayar ise tüm ağırlıkları eğitir. 32-bit ağırlık (4 bayt), gradyan (4 bayt) ve Adam’ın iki durum değişkeni (8 bayt) toplandığında parametre başına yaklaşık 16 bayt eder. 8 milyar parametrede bu, ara hesaplar hariç yaklaşık 128 GB demektir.
| Yöntem | Taban ağırlık | Eğitilen kısım | Tipik kullanım |
|---|---|---|---|
| QLoRA | 4-bit, dondurulmuş | Yalnızca LoRA katmanları | Sınırlı VRAM ile büyük model |
| LoRA | 16-bit, dondurulmuş | Yalnızca LoRA katmanları | Daha yüksek hassasiyet, daha çok VRAM |
| Tam ince ayar | 32-bit veya karma | Tüm ağırlıklar | Modelin derin dönüşümü, araştırma |
Şu durumdaysanız şunu seçin: Kurumsal üslup, alan terminolojisi ve belirli bir çıktı biçimi öğretecekseniz QLoRA ile başlayın. Sonuçlar hassasiyet nedeniyle yetersiz kalıyorsa ve belleğiniz varsa LoRA’ya geçin. Tam ince ayarı yalnızca adaptörlerin yetmediğini ölçtüğünüzde değerlendirin.
Fine Tuning İçin Kaç GB VRAM Gerekir?
Fine tuning için gereken VRAM, QLoRA’da 7–8 milyarlık modelde yaklaşık 10–16 GB, 70 milyarlık modelde 48 GB civarındadır. Aynı model LoRA veya tam ince ayarla çok daha fazlasını ister. Aşağıdaki tablo parametre başına bellek hesabına ve QLoRA çalışmasındaki ölçeğe dayanır.
| Model sınıfı | Çıkarım FP16 | Çıkarım 4-bit | QLoRA (4-bit) | LoRA (16-bit) | Tam ince ayar |
|---|---|---|---|---|---|
| 7–8 milyar | 14–16 GB | 4–5 GB | 10–16 GB | 20–24 GB ve üzeri | 120 GB ve üzeri |
| 13–14 milyar | 26–28 GB | 7–9 GB | 16–24 GB | 36–48 GB | 220 GB ve üzeri |
| 32 milyar | 64 GB | 16–20 GB | 32–48 GB | 80 GB ve üzeri | 500 GB ve üzeri |
| 70 milyar | 140 GB | 35–42 GB | 48 GB civarı, 80 GB rahat | 160 GB ve üzeri | 1 TB ve üzeri |
Yaklaşık değerlerdir. Gerçek tüketim batch boyutu, dizi uzunluğu, LoRA derecesi (r) ve kütüphane sürümüne göre değişir; çıkarım sütunlarına üretim sırasındaki KV önbelleğini ayrıca eklemeniz gerekir. Bu aralıkları bir kapasite sözü olarak değil, kart seçimi için başlangıç noktası olarak kullanın.
Bellek sınırına yaklaştığınızda ilk başvuracağınız ayarlar şunlardır: Dizi uzunluğunu kısaltmak, batch’i küçültüp gradyan biriktirme kullanmak ve gradyan kontrol noktalarını açmak. Bu üç ayar genelde VRAM’i azaltır, ancak son ikisi eğitimi yavaşlatır. Yani daha küçük bir kartla iş bitebilir ama süre uzar.
Kart içi bellek aralıklarını ürün yapılandırmalarıyla eşlemek isterseniz tabloyu şöyle okuyun: 8–16 GB yalnızca küçük modellerin QLoRA denemesine, 24 GB 7–14 milyarlık QLoRA işlerine, 48 GB 32 milyarlık QLoRA ve 14 milyarlık LoRA işlerine, 80 GB ve üzeri 70 milyarlık modellere karşılık gelir.
Kendi modeliniz için hesabı nasıl yaparsınız?
Hesabı üç satırda yapabilirsiniz. Önce model kartından toplam parametre sayısını alın ve yönteme göre çarpın: QLoRA için yaklaşık 0,55, LoRA için 2 bayt. Üstüne katmanların ara hesapları için güvenli bir pay ekleyin ve sonucu bir üst kart kademesine yuvarlayın.
Örneğin 14 milyarlık bir modelin 4-bit ağırlıkları yaklaşık 7,7 GB eder. Dizi uzunluğu ve batch makul tutulduğunda toplam ihtiyaç 16–24 GB bandına oturur, bu da 24 GB’lık yapılandırmaya işaret eder. Uzun dizilerle veya büyük batch ile çalışacaksanız aynı işi 48 GB’ta planlayın.
Eğitim süresini nasıl tahmin edersiniz?
Süreyi yayınlanmış bir benchmark’tan değil, kendi kurulumunuzdan ölçerek bulmak en güvenilir yoldur. Gerçek veriyle yüz kadar adım çalıştırıp adım başına süreyi kaydedin. Bu değeri toplam adım sayısıyla çarptığınızda doğrulama ve kayıt süreleri hariç bir tahmin elde edersiniz.
Toplam adım sayısı, örnek sayısının batch boyutuna bölümü ile epoch sayısının çarpımıdır. Gradyan biriktirme kullanıyorsanız güncelleme sayısının azaldığını, ancak işlenen örnek sayısının değişmediğini hesaba katın. Kart seçimini etkileyen asıl değer budur: Saat cinsinden süre, kiralama süresini ve projenin bütçesini belirler.
Çoklu GPU belleği gerçekten toplar mı?
Hayır, standart dağıtık eğitimde çoklu GPU belleği toplamaz; her kart modelin kendi kopyasını tutar. İki adet 24 GB’lık kart, 48 GB’lık bir model alanı sağlamaz. Eğitim hızlanır, ancak modelin sığma sınırı tek kartın VRAM’i olarak kalır.
Modeli katman katman kartlara bölmek de mümkündür, ama bu durumda her adımda veriler kartlar arasında taşınır. Kartlar arası bağlantının hızı burada belirleyicidir ve bölme ayarı çoğu zaman elle yapılır. Sığmayan bir modeli zorlamak yerine önce QLoRA’ya geçmeyi veya daha büyük VRAM’li tek karta çıkmayı değerlendirin.
Tam ince ayar gibi gerçekten çoklu GPU isteyen işlerde dağıtık eğitim kütüphaneleri, kart sayısı ve kartlar arası bağlantı birlikte planlanır. Bu yüzden Önem Bilişim’de çoklu GPU yapılandırmaları fiyat listesiyle değil, iş yükünüze göre hazırlanan teklifle sunulur.
Llama ve DeepSeek Modellerinin Hangi Sürümleri Tek Sunucuya Sığar?
Llama 3 ailesinin 8 ve 70 milyarlık sürümleri ile DeepSeek’in damıtılmış modelleri tek sunucuda ince ayara uygundur; 671 milyar ve üzerindeki büyük DeepSeek modelleri ise tek sunucu işi değildir. Karar verirken modelin adındaki sayıya değil, ağırlık dosyasındaki toplam parametreye bakın.
Llama tarafında 8 ve 70 milyarlık modeller Llama 3 ile geldi, Llama 3.1 ve 3.3 ile yenilendi. Bu yazı güncellenirken Hugging Face’teki Meta hesabındaki en yeni büyük açık ağırlık ailesi Llama 4’tür. Scout ve Maverick sürümlerinin adında “17B” geçse de bu değer etkin parametreyi ifade eder; toplam ağırlık sayısı Scout’ta yaklaşık 109 milyar, Maverick’te yaklaşık 402 milyardır.
DeepSeek tarafında R1 model kartı, Qwen ve Llama tabanlı 1,5, 7, 8, 14, 32 ve 70 milyar parametreli damıtılmış sürümleri listeler. Ana R1 modeli ise 671 milyar toplam parametreli bir MoE mimarisidir. DeepSeek V4 ailesinde Flash yaklaşık 291 milyar, Pro yaklaşık 1,6 trilyon parametreye ulaşır.
| Model | Toplam parametre | Tek sunucuda gerçekçi yöntem | Başlangıç VRAM’i |
|---|---|---|---|
| Llama 3.1 8B, DeepSeek-R1-Distill-Llama-8B | Yaklaşık 8 milyar | QLoRA, LoRA | 24 GB |
| DeepSeek-R1-Distill-Qwen-14B | Yaklaşık 14 milyar | QLoRA, LoRA | 24–48 GB |
| DeepSeek-R1-Distill-Qwen-32B | Yaklaşık 32 milyar | QLoRA | 48 GB |
| Llama 3.1 70B, DeepSeek-R1-Distill-Llama-70B | Yaklaşık 70 milyar | QLoRA | 48 GB sınırda, 80 GB rahat |
| Llama 4 Scout | Yaklaşık 109 milyar | QLoRA, deneme düzeyinde | 80 GB ve üzeri, çoklu GPU |
| DeepSeek-R1 ve V3 (671 milyar), V4 ailesi | 291 milyar – 1,6 trilyon | Tam ince ayar çok düğümlü küme işidir | Tek sunucu önermiyoruz |
671 milyar parametreli bir modelin 4-bit ağırlıkları bile yaklaşık 370 GB tutar, tam ince ayarda parametre başına 16 bayt hesabı 10 TB’ın üzerine çıkar. Bu yüzden DeepSeek deneylerinizi damıtılmış modellerle planlayın. Lisansı da kontrol edin: R1 ağırlıkları MIT lisanslıdır, damıtılmış sürümler ise taban aldıkları Qwen veya Llama modelinin koşullarını taşır ve Llama modellerinde Meta’nın lisans onayı gerekir.
RAM ve NVMe Eğitim Hızını Nasıl Etkiler?
RAM ve NVMe eğitimi doğrudan etkiler, çünkü kart yalnızca veriyi zamanında alabildiği sürece çalışır. Pratik kural, sistem RAM’ini toplam VRAM’in en az iki katı tutmaktır. Model yüklenirken ağırlıklar önce sistem belleğine alınır, veri yükleyici işçileri de ayrıca bellek kullanır.
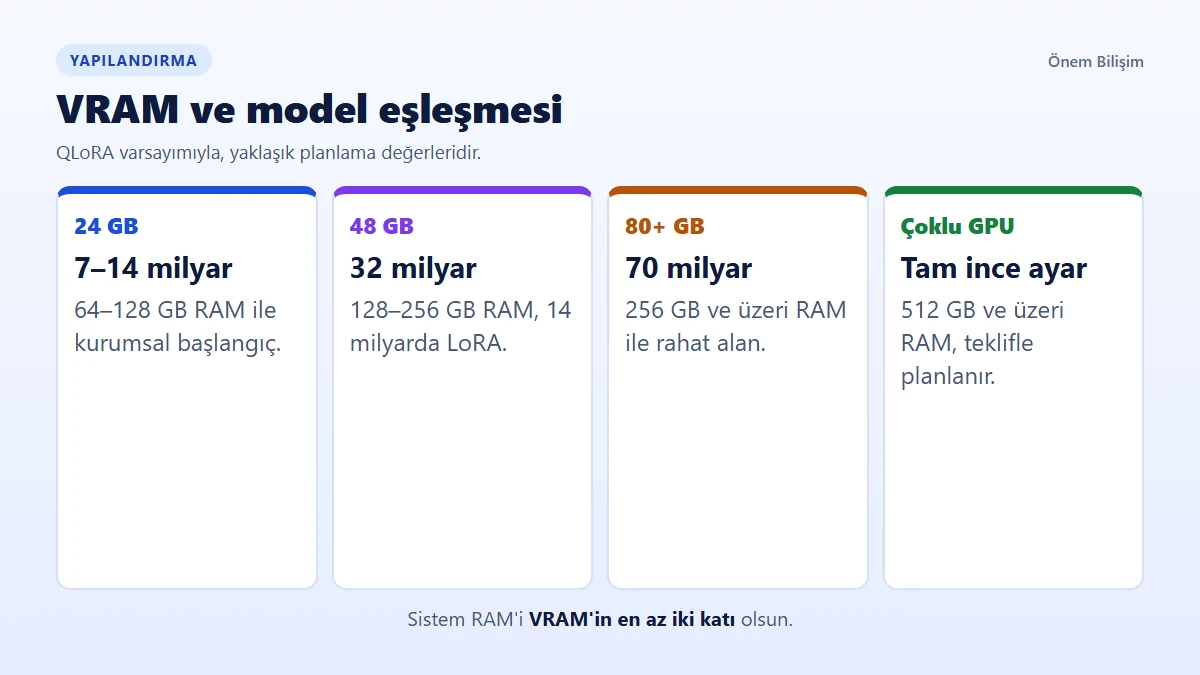
Bu kuralı Önem Bilişim yapılandırmalarına uyguladığınızda 24 GB VRAM için en az 64 GB, 48 GB VRAM için en az 128 GB, 80 GB ve üzeri VRAM için 256 GB ve üzeri RAM anlamlıdır. Çoklu GPU kurulumlarında hesabı kartların toplam VRAM’i üzerinden yapın. Eğitim veri setiniz büyükse bir kademe yukarı çıkmak veri önbelleğini sistem belleğinde tutmanızı sağlar.
NVMe ise iki noktada kendini gösterir: Veri setini okurken ve kontrol noktası yazarken. Parçalı okumalarda SATA SSD ile NVMe arasındaki farkı NVMe ve SSD karşılaştırması yazısında anlattık. 70 milyarlık modelin FP16 ağırlıkları tek başına yaklaşık 140 GB yer kapladığından modeller, veri seti ve kontrol noktaları için kapasiteyi önceden hesaplayın.
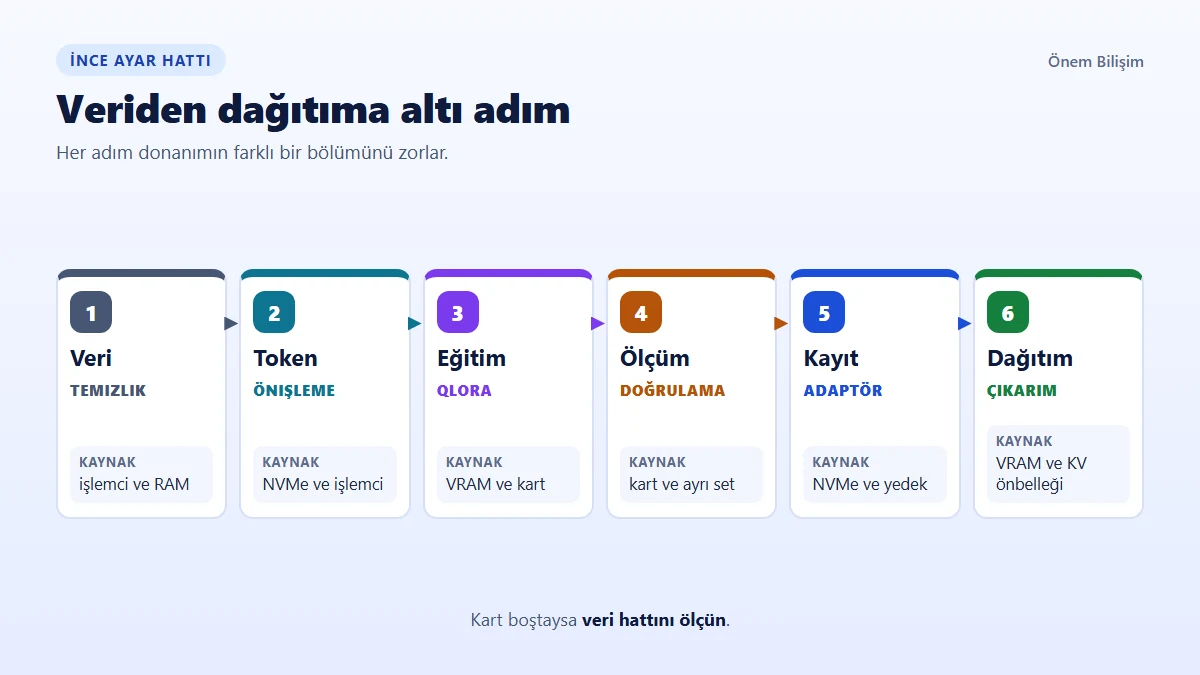
Darboğazı ölçmek basittir. nvidia-smi çıktısında GPU kullanımı sürekli düşüp yükseliyorsa kart veri bekliyor demektir. Bu durumda önce veri yükleyici işçi sayısını artırın, tokenize edilmiş veriyi diske önceden yazın ve ancak sonra daha büyük kart aramaya başlayın.
Hugging Face PEFT ile QLoRA Eğitimi Nasıl Kurulur?
Hugging Face PEFT ile QLoRA, modeli BitsAndBytesConfig ile 4-bit yükleyip üzerine LoraConfig ile adaptör ekleyerek kurulur. Aşağıdaki iskelet 8 milyarlık bir modeli NF4 nicemlemesiyle hazırlar. Parametreleri kendi veri setinize göre ayarlamanız gerekir.
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

ayar = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    "deepseek-ai/DeepSeek-R1-Distill-Llama-8B",
    quantization_config=ayar,
)
model = prepare_model_for_kbit_training(model)

lora = LoraConfig(r=16, lora_alpha=32, lora_dropout=0.05, task_type="CAUSAL_LM")
model = get_peft_model(model, lora)
model.print_trainable_parameters()
Son satır, eğitilecek parametrelerin toplamın ne kadarı olduğunu yazdırır ve kurulumun doğru yapıldığını gösteren ilk kontroldür. Eğitim için device_map="auto" kullanmayın; Hugging Face belgeleri bu ayarı çıkarım için önerir. Eğitim bittiğinde adaptörü ayrı kaydedebilir veya merge_and_unload() ile taban modele birleştirebilirsiniz.
Ortamı tekrarlanabilir kılmak için eğitimi bir kapsayıcı içinde çalıştırmanızı öneririz. Docker ile mikroservis yapılandırması yazısındaki temeller burada da geçerlidir, ek olarak kapsayıcının karta erişmesi için NVIDIA Container Toolkit gerekir. Kurulumu şu komutla doğrulayın:
sudo docker run --rm --runtime=nvidia --gpus all ubuntu nvidia-smiKomut kart listesini gösteriyorsa kapsayıcı karta erişiyor demektir. Önem Bilişim GPU fiziksel sunucularında NVIDIA sürücüsü, CUDA Toolkit ve NVIDIA Container Toolkit için kurulum desteği alabilirsiniz.
GPU VDS Bu Sürecin Neresinde Kullanılır?
GPU VDS bu süreçte eğitim için değil, veri hazırlığı ve hattın çok küçük bir modelle denenmesi için kullanılır. Paketlerdeki 1–4 GB VRAM, bu yazıdaki hiçbir LLM ince ayar senaryosuna yetmez ve kartın işlem birimleri zaman paylaşımlıdır. Bu nedenle uzun eğitimler için önerilmez.
GPU destekli sanal sunucu üzerinde verinizi temizleyebilir, tokenizasyon betiklerini yazabilir, birkaç yüz milyon parametrelik küçük bir modelle eğitim döngüsünün hatasız çalıştığını görebilirsiniz. Önce burada prototipleyin, gerçek modeli eğitmeye geldiğinizde fiziksel sunucuya geçin. Bu ayrımın ayrıntısını VDS ve fiziksel sunucu kıyasında bulabilirsiniz.
Aynı mantık alan verisiyle çalışan başka projeler için de geçerlidir. Örneğin biyoinformatik GPU projelerinde hem verinin gizliliği hem de kart belleği, altyapı kararını baştan belirler.
Hangi Yapılandırma Hangi Modele Uyar?
Çoğu kurumsal ince ayar projesi için 24 GB ile başlamak, 70 milyarlık modellerde 80 GB ve üzerine çıkmak doğru plandır. Aşağıdaki eşleştirme QLoRA varsayımıyla hazırlanmıştır. Kart adedi ve güncel kart listesi teklif aşamasında paylaşılır.
| Hedefiniz | VRAM | Sistem RAM’i | Not |
|---|---|---|---|
| Küçük model, QLoRA denemesi | 8–16 GB | 64 GB | Batch küçük, dizi kısa tutulur |
| 7–14 milyarlık model, QLoRA | 24 GB | 64–128 GB | Kurumsal asistanlar için tipik başlangıç |
| 32 milyarlık QLoRA, 14 milyarlık LoRA | 48 GB | 128–256 GB | Hassasiyet ile hız arasında denge |
| 70 milyarlık QLoRA | 80 GB ve üzeri | 256 GB ve üzeri | 48 GB ile de olur ama sınırda çalışır |
| LoRA ile 70 milyar, tam ince ayar | Çoklu GPU | 512 GB ve üzeri | Mimari teklifte birlikte planlanır |
Modeliniz sınırda çalışacaksa yüksek VRAM’li fiziksel sunucu seçerken bir kademe yukarıyı düşünün. Eğitim süresini kısaltmaktan çok, bellek hatası yüzünden saatler sonra başa dönmeyi önlersiniz. Proje kısa süreliyse 1, 3 veya 6 aylık ve proje bazlı kiralama da mümkündür.
Sahadan Not: Tam eğitimi başlatmadan önce veri setinizdeki en uzun örnekleri başa alıp kısa bir prova çalıştırın. Bellek taşması saatler sonra değil, ilk dakikalarda ortaya çıkar. Aynı provada kontrol noktası kaydını ve yüklemesini de deneyin; kayıt adımındaki bir hata en pahalı hatalardan biridir.
Sık Sorulan Sorular
İnce ayar için ne kadar veri gerekir?
Sabit bir sayı yoktur; gereken miktar görevin darlığına ve örneklerin kalitesine bağlıdır. Dar bir görevde birkaç yüz temiz örnekle anlamlı bir fark görebilirsiniz, geniş alan bilgisi için çok daha fazlası gerekir. Az sayıda iyi örnek, çok sayıda gürültülü örnekten daha değerlidir. Küçük başlayın, ayrı bir doğrulama setiyle ölçün ve veriyi ihtiyaca göre artırın.
Fine tuning mı RAG mı kullanmalıyım?
Sık değişen belgelerden doğru bilgi getirmek istiyorsanız RAG daha uygundur, çünkü modeli yeniden eğitmeden veriyi güncellersiniz. Üslup, biçim veya belirli bir görevin davranışını öğretmek istiyorsanız ince ayar öne çıkar. İkisi birbirinin alternatifi olmak zorunda değildir. Birçok proje ince ayarlı modeli RAG hattıyla birlikte çalıştırır ve önce RAG ile başlamak maliyeti düşürür.
LoRA adaptörü ne kadar yer kaplar?
LoRA adaptörü taban modele kıyasla küçüktür; boyutu LoRA derecesine ve hedeflenen katman sayısına göre değişir ve çoğu projede megabaytlar ile birkaç yüz megabayt arasında kalır. Bu sayede aynı taban model üzerinde birden çok adaptör saklayabilirsiniz. Çıkarım sırasında taban modelin yine belleğe yüklenmesi gerektiğini unutmayın. Adaptörü sonradan taban modelle birleştirmek gecikmeyi azaltabilir.
İnce ayarlı modeli küçük bir sunucuda çalıştırabilir miyim?
Modelin ağırlıkları ve KV önbelleği sunucunun VRAM’ine sığıyorsa evet. 4-bit nicemlenmiş 7–8 milyarlık bir model için ağırlıklar yaklaşık 4–5 GB tutar, üstüne üretim belleği gelir; bu yüzden 4 GB VRAM yeterli değildir. Üretimde beklenen eş zamanlı istek sayısını da hesaba katın. Küçük kartlarda yalnızca birkaç yüz milyon parametrelik modeller gerçekçidir.
Eğitilen modelin ticari kullanımı serbest mi?
Bu, taban modelin lisansına bağlıdır. DeepSeek-R1 ağırlıkları MIT lisanslıdır; Qwen tabanlı damıtılmış sürümler Apache 2.0, Llama tabanlı olanlar ise Llama lisans koşullarını taşır. Llama modellerinde kullanıcı sayısına bağlı koşullar ve isimlendirme kuralları bulunabilir. Ticari kullanımdan önce model kartındaki güncel lisans metnini okuyun, gerekirse hukuk danışmanınızla değerlendirin.
Eğitim yarıda kesilirse çalışmam kaybolur mu?
Düzenli kontrol noktası alıyorsanız kaybolmaz; Hugging Face Trainer belirlediğiniz adım aralığında durumu kaydeder ve resume_from_checkpoint ile kaldığınız yerden devam edersiniz. Adım aralığını kontrol noktası yazma süresine göre seçin. Kontrol noktalarını aynı diskte tutmak donanım arızasına karşı koruma sağlamaz, bu yüzden önemli aşamaları sunucu dışına kopyalayın.
Sonuç: LLM Fine Tuning Donanım Gereksinimleri İçin Karar
LLM fine tuning donanım gereksinimlerinde doğru başlangıç QLoRA ve 24 GB VRAM’dir; 32 milyarlık modellerde 48 GB, 70 milyarlık modellerde 80 GB ve üzerini seçin, RAM’i VRAM’in en az iki katı tutun. Tam ince ayarı ve 671 milyarlık DeepSeek modellerini tek sunucu planına koymayın.
Model boyutunuzu ve veri setinizi WhatsApp veya teklif formundan iletin; yapılandırmayı birlikte netleştirelim. Yıllık alımlardaki 10 ay öde, 12 ay kullan avantajını teklif sırasında sorabilir, 7/24 Türkçe destek ekibimizden kurulum için yardım alabilirsiniz.
GPU fiziksel sunucu
Modelinize uygun VRAM’i birlikte planlayalım
Model boyutunuzu, yönteminizi ve veri setinizin büyüklüğünü iletin; VRAM, RAM ve disk yapılandırmasını projenize özel teklifle netleştirelim.
Önem Bilişim Teknik Ekibi
2019’dan beri hizmet veren, ETBİS kayıtlı bir sunucu ve yazılım hizmetleri şirketiyiz. GPU VDS, fiziksel sunucu ve barındırma hizmetlerimizde 7/24 Türkçe teknik destek sunuyoruz.
Son güncelleme: 9 Kasım 2026