 Ekonomik SSD Hosting
 VDS Kirala
 Ryzen VDS
 Discord VDS
 Sunucu Barındırma
 Fiziksel Sunucu
 Rust Server Kirala
 Minecraft Server Kirala
 CS2 Server Kirala
 Unturned Server Kirala
 MTA Server Kirala
 FiveM Server Kirala
 Garry's Mod Server Kirala
 Palworld Server Kirala
 Valheim Server Kirala
 Layer 7 Koruma
 Rust Plugin Paket
 Yazılım Hizmetleri
Yapay Zeka Eğitimi İçin GPU VDS vs. Fiziksel GPU Sunucu: Hangisini Seçmelisiniz?
Prototip, inference, ince ayar ve sıfırdan eğitim için hangi GPU altyapısının gerektiğini VRAM, vGPU zaman paylaşımı ve gerçek iş yükü üzerinden karşılaştırıyoruz.
İçindekiler
- Yapay Zeka Eğitimi İçin GPU Sunucu Seçimi Neden İş Yüküyle Başlar?
- Eğitim ve Inference Farkı VRAM’e Nasıl Yansır?
- Model eğitimi için VRAM nasıl hesaplanır?
- vGPU Zaman Paylaşımı Eğitim Süresini Nasıl Etkiler?
- Prototip, Inference, İnce Ayar ve Sıfırdan Eğitim İçin Karar Tablosu
- Prototip ve kod doğrulama
- Inference sunucusu
- İnce ayar (fine-tuning)
- Sıfırdan eğitim
- Kartın Dışındaki Darboğazlar Eğitimi Nasıl Yavaşlatır?
- Hangi Paket, Hangi Yapılandırma?
- En sık yapılan üç seçim hatası
- GPU VDS’ten Fiziksel Sunucuya Ne Zaman Geçmelisiniz?
- Sık Sorulan Sorular
- Eğitim sırasında VRAM yetmezse ne olur?
- Birden fazla GPU kullanınca VRAM toplanır mı?
- Eğitilmiş modeli servis etmek için eğitimdeki donanım gerekir mi?
- Eğitimde işlemci çekirdeği ne kadar önemli?
- Eğitim yarıda kesilirse ilerleme kaybolur mu?
- Hassas veriyle model eğitirken nelere dikkat etmeliyim?
- Sonuç: Yapay Zeka Eğitimi İçin GPU Sunucu Kararı
Yapay zeka eğitimi için GPU sunucu ararken çoğu ekip önce fiyata bakıyor, sonra modelin kartın belleğine sığmadığını görüyor. Aylık sabit ücretli küçük bir GPU VDS ile GPU fiziksel sunucu kiralama arasındaki tercih, bütçeden önce bir iş yükü sorusudur. Bir sınıflandırma modelini servis etmek, 8 milyar parametreli bir dil modeline ince ayar yapmak ve bir modeli sıfırdan eğitmek çok farklı donanımlar ister. Yazının sonunda işinizin hangi aşamada olduğunu, buna hangi ürünün uyduğunu ve fiziksel sunucuya ne zaman geçmeniz gerektiğini netleştirmiş olacaksınız.
Kısa Cevap: Modeli eğitiyor veya ince ayar yapıyorsanız GPU fiziksel sunucu, küçük bir modeli servis ediyor ya da kodunuzu test ediyorsanız GPU VDS doğru seçimdir. GPU VDS paketleri 1–4 GB VRAM sunar; bu bellek LLM eğitimi ve ağır yapay zeka işleri için yeterli değildir. Önce VDS’te prototipleyin, iş büyüyünce kartın tamamına geçin.
Yapay Zeka Eğitimi İçin GPU Sunucu Seçimi Neden İş Yüküyle Başlar?
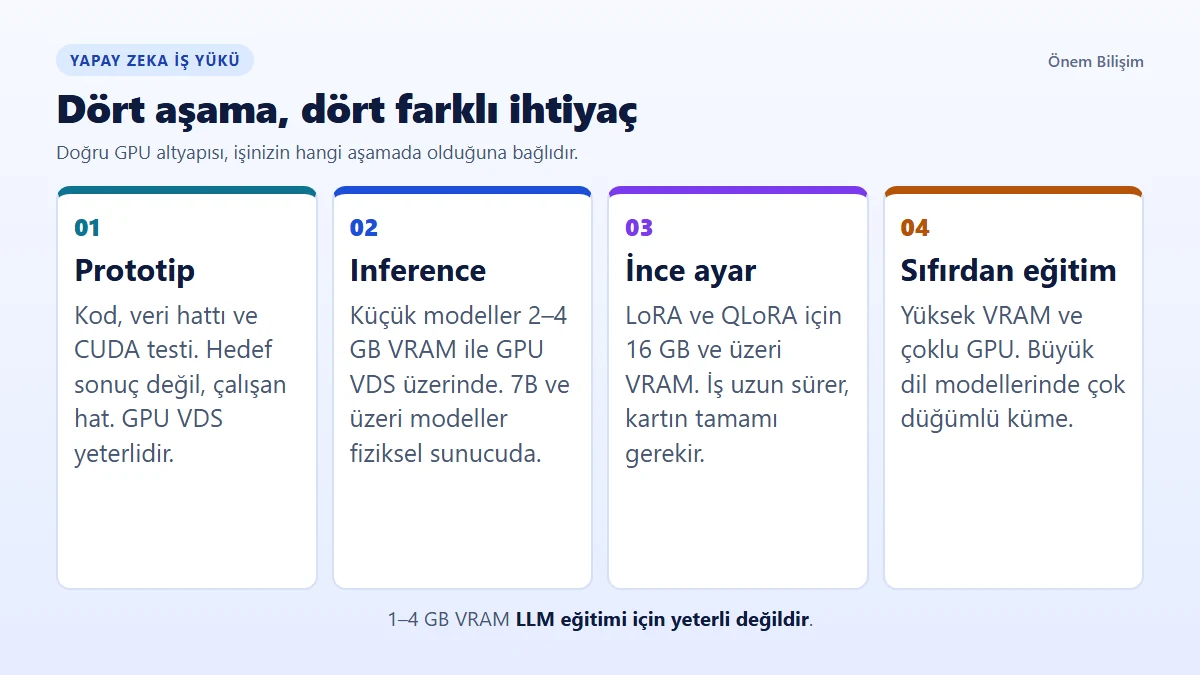
Yapay zeka eğitimi için GPU sunucu seçimi iş yüküyle başlar, çünkü aynı model farklı aşamalarda kat kat farklı kaynak tüketir. Tek bir “yapay zeka sunucusu” tanımı bu yüzden yanıltıcıdır. Önce elinizdeki işin dört aşamadan hangisine girdiğini belirleyin.
- Prototip: Kodun, veri hattının ve kütüphane sürümlerinin çalıştığını görmek istersiniz. Sonucun kalitesi henüz önemli değildir.
- Inference: Eğitilmiş modeli çalıştırıp yanıt üretirsiniz. Burada belirleyici olan gecikme ve eş zamanlı istek sayısıdır.
- İnce ayar (fine-tuning): Hazır bir modeli kendi verinizle uyarlarsınız. Süre saatler veya günlerle ölçülür, VRAM ilk sınırdır.
- Sıfırdan eğitim: Ağırlıkların tamamını kendiniz öğretirsiniz. Veri hacmi, kart adedi ve süre birlikte büyür.
İlk iki aşamanın bir bölümü küçük bir vGPU diliminde yürür. Son iki aşama ise kartın belleğine ve işlem gücüne sürekli yüklendiği için ayrılmış donanım ister. Sanal ve ayrılmış sunucu arasındaki temel ayrımı hatırlamak isterseniz fiziksel sunucunun çalışma mantığını anlattığımız yazıya bakabilirsiniz.
Eğitim ve Inference Farkı VRAM’e Nasıl Yansır?
Eğitim, aynı model için inference’a göre birkaç kat daha fazla VRAM ister, çünkü kart yalnızca ağırlıkları değil gradyanları ve optimizer durumunu da taşır. Inference tarafında bellek çoğunlukla model ağırlıklarına ve dil modellerinde KV cache denilen ara belleğe gider. 16-bit kayan noktada (FP16) kaba hesap parametre sayısı × 2 bayttır.
Eğitimde tablo değişir. Adam optimizer her parametre için iki ek durum tutar; gradyan ve ağırlıkla birlikte parametre başına dört kopya eder. Ağırlıklar 32-bit kaldığında bu yaklaşık 16 bayt demektir. PyTorch’un karma hassasiyet özelliği aktivasyonların önemli bir kısmını FP16’ya çekerek yardımcı olur, ancak optimizer yükünü ortadan kaldırmaz.
Aşağıdaki değerler 8 milyar parametreli bir model için yaklaşık hesaplardır. Batch boyutu, dizi uzunluğu ve kütüphane sürümü sonucu değiştirir, bu yüzden tabloyu kesin ölçü olarak değil planlama başlangıcı olarak kullanın.
| Senaryo | Yaklaşık VRAM | Kartta ne tutulur? |
|---|---|---|
| Inference, FP16 | 16 GB + KV cache | Ağırlıklar ve ara bellek |
| Inference, 4-bit | 4–5 GB + KV cache | Kuantize ağırlıklar ve ara bellek |
| QLoRA ince ayar (4-bit) | 10–16 GB | Donuk 4-bit model, küçük adaptör, gradyanlar |
| LoRA ince ayar (16-bit) | 20–24 GB ve üzeri | FP16 model, adaptör, gradyanlar |
| Tam ince ayar (karma hassasiyet + Adam) | 120 GB ve üzeri, çoklu GPU | Tüm ağırlıklar, gradyanlar, optimizer durumu |
LoRA’nın avantajı buradan gelir: Modelin gövdesi donuk kalır, yalnızca küçük adaptör matrisleri öğrenilir. QLoRA makalesi, bu yaklaşımla 65 milyar parametreli bir modelin tek bir 48 GB’lık GPU’da ince ayarının yapılabildiğini gösterir. Yani doğru yöntem, ihtiyaç duyduğunuz VRAM’i kat kat düşürebilir, ama 1–4 GB seviyesine indirmez.
Model eğitimi için VRAM nasıl hesaplanır?
Model eğitimi için VRAM ihtiyacını parametre sayısı, hassasiyet ve yöntem üzerinden kabaca hesaplayabilirsiniz. Önce modelin parametre sayısını öğrenin. Model kartında yazmıyorsa modeli CPU üzerinde yükleyip sayabilirsiniz:
n = sum(p.numel() for p in model.parameters())
print(f"{n / 1e9:.1f} milyar parametre")
Sonra yönteminize göre bayt çarpanını uygulayın. FP16 inference için yaklaşık 2, 4-bit için yaklaşık 0,5–0,6, karma hassasiyet ve Adam ile tam eğitim için yaklaşık 16 bayt kullanın. Çıkan sayıya aktivasyonlar ve batch için pay ekleyin, çünkü uzun dizilerde bu pay hızla büyür.
Örneğin 8 milyar parametreli bir modeli 16-bit LoRA ile uyarlayacaksanız ağırlıklar tek başına yaklaşık 16 GB tutar. Aktivasyonlar ve gradyanlarla birlikte ihtiyaç 20–24 GB ve üzerine çıkar. Bu yüzden 24 GB’lık bir kart bu iş için rahat değil, ancak yeterli seviyededir. Uzun diziler veya büyük batch kullanacaksanız bir kademe üstünü değerlendirin.
vGPU Zaman Paylaşımı Eğitim Süresini Nasıl Etkiler?
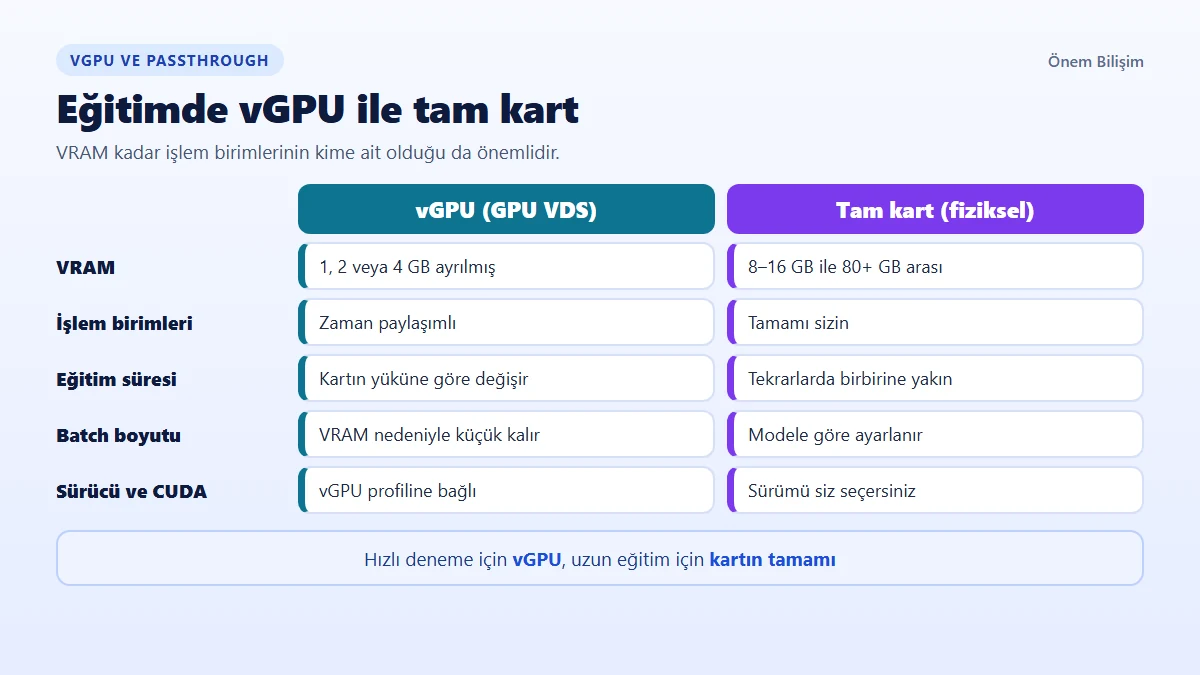
vGPU’da VRAM size ayrılır ama işlem birimleri zaman paylaşımlıdır; bu yüzden eğitim süresi kartın o anki yüküne göre uzar ve önceden kestirmesi zorlaşır. vGPU ve passthrough farkı eğitim açısından tek cümleye iner: Passthrough’ta işlem döngülerinin tamamı sizindir, vGPU’da ise sıra size geldiğinde çalışırsınız.
Sıranın nasıl dağıtıldığını zamanlayıcı politikası belirler. NVIDIA vGPU belgelerine göre varsayılan “best effort” politikası, diğer vGPU’ların kullanmadığı döngüleri kullanmanıza izin verir. “Equal share” ve “fixed share” politikaları ise her dilime üst sınır koyar. Kullanacağınız NVIDIA vGPU destekli VDS üzerinde performans bu nedenle yoğun saatlerde değişebilir.
Etkiyi varsayımsal bir örnekle görelim. Tam kartta 20 saat süren bir eğitim, işlem döngülerinin yarısını alabildiğiniz bir dilimde yaklaşık 40 saate, üçte birini alabildiğinizde yaklaşık 60 saate çıkar. Komşu iş yükleri gün içinde değiştiği için bu süre sabit de kalmaz.
Zaman paylaşımı tek fren değildir. Küçük VRAM batch boyutunu da düşürür, bu da bir epoch’taki adım sayısını artırır. Gradyan biriktirme büyük batch’in etkisini taklit ederek belleği kurtarır, süreyi kurtarmaz. Ayrıca kartın hızı dalgalandığında iki deneyin süresini karşılaştırmak da güvenilirliğini yitirir.
Inference tarafında etki farklı görünür. Ortalama yanıt süresi kabul edilebilir kalsa bile en yavaş isteklerin süresi, yani p95 ve p99 gecikmesi dalgalanabilir. Küçük bir sınıflandırma servisi için bu çoğu zaman sorun olmaz. Sıkı gecikme hedefi olan bir canlı üründe ise ölçmeden karar vermeyin.
Prototip, Inference, İnce Ayar ve Sıfırdan Eğitim İçin Karar Tablosu
Prototip ve küçük model inference’ı GPU VDS’e, ince ayar ve sıfırdan eğitim GPU fiziksel sunucuya aittir. Aşağıdaki tablo bu ayrımı somut iş yükleriyle eşleştirir.
| İş yükü | Doğru ürün | Gerekçe |
|---|---|---|
| CUDA kodu derleme, veri hattı testi | GPU VDS (Başlangıç, Standart, Plus) | Az VRAM yeter, amaç kodun çalışmasıdır |
| Küçük görüntü sınıflandırma, metin işleme inference’ı | GPU VDS (Pro, Ultra) | Model birkaç yüz MB, 2–4 GB VRAM’e sığar |
| 7–8B dil modeli inference’ı | Fiziksel sunucu, 16–24 GB VRAM | FP16 ağırlıklar tek başına 14–16 GB tutar |
| 70B dil modeli inference’ı | Fiziksel sunucu, 48–80+ GB VRAM | 4-bit’te bile onlarca GB gerekir |
| 7–8B QLoRA veya LoRA ince ayarı | Fiziksel sunucu, 16–24 GB VRAM | Eğitim günlerce sürebilir, VRAM ayrılmış olmalı |
| 70B QLoRA ince ayarı | Fiziksel sunucu, 48–80+ GB VRAM | 48 GB sınırda çalışır, 80 GB rahat eder |
| Görüntü modeli sıfırdan eğitimi | Fiziksel sunucu, 24–48 GB VRAM, gerekirse çoklu GPU | Büyük batch ve hızlı NVMe gerekir |
| Büyük dil modeli sıfırdan eğitimi | Çoklu GPU, çoğu durumda çok düğümlü küme | Tek sunucu ölçeğini aşar, kapsam teklifte konuşulur |
Prototip ve kod doğrulama
Prototip aşamasında küçük bir vGPU dilimi çoğu zaman yeterlidir, çünkü hedef modeli eğitmek değil hattı doğrulamaktır. Veri okuma, tokenizasyon, kaydetme ve yükleme adımlarını çok küçük bir modelle uçtan uca çalıştırın. Hataların çoğu burada, ucuz donanımda ortaya çıkar. VRAM ve CUDA çekirdeği gibi kalemleri okumayı GPU kiralama kontrol listemizde ayrıca ele alıyoruz.
Inference sunucusu
Inference sunucusunun boyutunu modelin bellek ihtiyacı ve eş zamanlı istek sayısı birlikte belirler. 1 milyar parametreli bir dil modeli FP16’da yaklaşık 2 GB tutar. 1–3B sınıfı modelleri 4-bit ile Ultra paketin 4 GB’ına sığdırmayı deneyebilirsiniz, ama KV cache payını kendi trafiğinizle ölçün. 7B ve üzeri modellerde fiziksel sunucuya geçmek gerekir.
İnce ayar (fine-tuning)
İnce ayar, VRAM’in sürekli dolu kaldığı uzun bir iş olduğu için kartın tamamı size ayrılan GPU sunucu gerektirir. LoRA ve QLoRA yöntemleri Hugging Face PEFT kütüphanesiyle hazır gelir, bu yüzden en gerçekçi başlangıç noktasıdır. Model bazında VRAM eşleştirmesini LLM ince ayarı donanım rehberimizde detaylandırıyoruz.
Sıfırdan eğitim
Sıfırdan eğitimin ölçeği modelin türüne göre çok değişir. Bir nesne tespit modeli tek kartta makul sürede eğitilebilir; görüntü işleme projelerindeki GPU kullanımı bu tarafın ayrıntılarını içerir. Milyarlarca parametreli bir dil modelini sıfırdan eğitmek ise çoklu GPU ve çoğu durumda çok düğümlü küme işidir, tek sunucuyla çözüleceğini varsaymayın.
Kartın Dışındaki Darboğazlar Eğitimi Nasıl Yavaşlatır?
Kart tek başına hızı belirlemez; işlemci, sistem belleği, disk ve ağ yetişemezse GPU boşta bekler. Bu nedenle donanımı planlarken veri hattının tamamını birlikte düşünün. Sık atlanan dört nokta şunlardır:
- İşlemci: PyTorch DataLoader’ın işçi süreçleri veriyi okuyup hazırlar. GPU VDS’te EPYC 7H12’nin 4 veya 8 vCPU’su size ayrılır. Bu kapasite küçük işlere yeter, yoğun görüntü ön işlemede kartı beslemeye yetmeyebilir.
- Sistem belleği: Veri seti önbelleğe alınırken ve model karta yüklenmeden önce RAM’de durur. RAM yetersiz kaldığında sistem takasa düşer ve eğitim belirgin biçimde yavaşlar.
- Disk: Kapasite sanıldığından çabuk dolar. 8 milyar parametreli bir modelin FP16 ağırlıkları yaklaşık 16 GB tutar. Birkaç kontrol noktası, işletim sistemi, CUDA araçları ve Docker imajları eklendiğinde 35–50 GB’lık VDS diski hızla biter.
- Ağ: Port hızı, veri setini sunucuya taşıma süresini belirler. 100 GB’lık bir veri seti teorik olarak 10 Gbps portta yaklaşık 80 saniyede, 1 Gbps portta yaklaşık 13 dakikada aktarılır. Gerçek süre karşı tarafın hızına da bağlıdır.
Fiziksel sunucuda bu kalemlerin her biri iş yükünüze göre seçilir. Disk kapasitesini teklif aşamasında veri seti boyutu ve saklayacağınız kontrol noktası sayısına göre belirleyin. Çoklu GPU kullanacaksanız kartlar arası bağlantının ağ portundan ayrı bir konu olduğunu da hesaba katın.
Hangi Paket, Hangi Yapılandırma?
Hafif işlerde GPU VDS’in Pro veya Ultra paketi, eğitim ve ince ayarda ise VRAM’i iş yüküne göre seçilmiş bir fiziksel sunucu doğru başlangıçtır. GPU VDS tarafında NVIDIA T40 vGPU ve AMD EPYC 7H12 kullanılır; paketleri ve fiyatları sayfasından aylık ücretleri görebilirsiniz.
| İhtiyaç | Önem Bilişim karşılığı | Temel kaynaklar |
|---|---|---|
| CUDA testi, veri hattı provası | GPU VDS Başlangıç, Standart, Plus | 1 GB VRAM, 4 vCPU, 4–8 GB RAM |
| Küçük model inference’ı | GPU VDS Pro | 2 GB VRAM, 4 vCPU, 12 GB RAM |
| Daha yoğun küçük model servisi | GPU VDS Ultra | 4 GB VRAM, 8 vCPU, 16 GB RAM |
| Küçük görüntü modeli eğitimi, 7–8B QLoRA | Fiziksel sunucu | 8–16 GB VRAM, 64 GB RAM |
| 7–8B LoRA, rahat QLoRA | Fiziksel sunucu | 24 GB VRAM, 64 GB RAM |
| 70B QLoRA (sınırda), çoklu deney | Fiziksel sunucu | 48 GB VRAM, 128 GB RAM |
| 70B QLoRA (rahat) | Fiziksel sunucu | 80+ GB VRAM, 256 GB RAM |
| 8B tam ince ayar | Çoklu GPU fiziksel sunucu | 120+ GB toplam VRAM, 256–512 GB RAM |
Sistem RAM’ini toplam VRAM’in en az iki katı olarak planlayın; veri, karta gitmeden önce bellekte bekler. Güncel kart listesi teklifte paylaşılır, kart seçimini iş yükünüzle birlikte netleştirmek en sağlıklısıdır. VDS tarafında ise CUDA ve OpenCL desteği vGPU profiline ve sürücü sürümüne bağlıdır, bu yüzden kullanacağınız yazılımı siparişten önce canlı destekle doğrulayın.
Eğitim ile servisi aynı makinede tutmak zorunda değilsiniz. Fiziksel sunucu 1, 3, 6 veya 12+ ay ya da proje bazlı yapılandırılabildiği için eğitim dönemini ayrı planlayabilirsiniz. Eğitilen model 4 GB’a sığıyorsa servisi GPU VDS’e taşıyabilir, sığmıyorsa daha düşük VRAM’li bir fiziksel yapılandırmada sürdürebilirsiniz.
En sık yapılan üç seçim hatası
Birinci hata, modelin inference gereksinimine bakıp eğitim planlamaktır. 8 milyar parametreli bir model 16 GB’ta çalışıyor diye aynı kartta tam ince ayar yapılamaz. İkinci hata, düşük GPU kullanımını daha büyük kartla çözmeye çalışmaktır, oysa kart çoğu zaman veriyi bekliyordur.
Üçüncü hata yalnızca bugünkü deneyi hesaba katmaktır. Veri seti büyüdüğünde disk ve RAM ihtiyacı da büyür, deney sayısı arttığında kontrol noktaları birikir. Yapılandırmayı bir sonraki aşamanızı da düşünerek seçin; paketler arası yükseltme ve kart ekleme seçeneklerini başlangıçta konuşmak sonradan zaman kazandırır.
GPU VDS’ten Fiziksel Sunucuya Ne Zaman Geçmelisiniz?
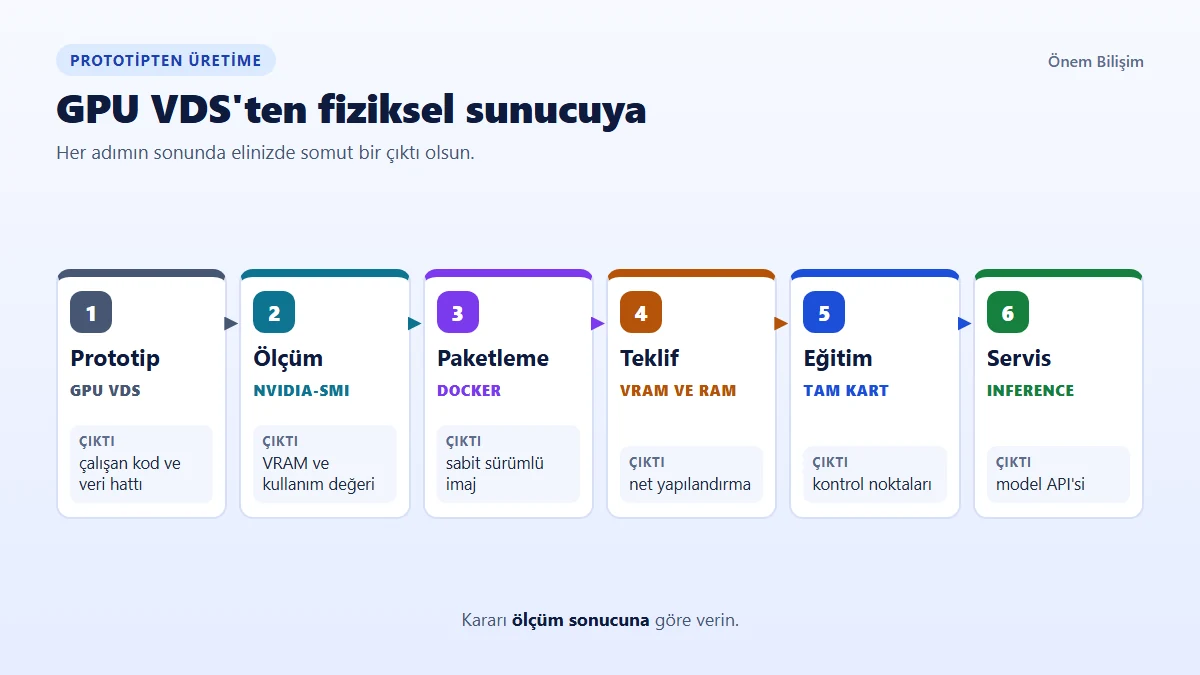
Modeliniz veya batch’iniz 4 GB’a sığmıyorsa, eğitim süresi teslim planınızı bozuyorsa ya da veriniz hassassa geçiş zamanı gelmiştir. Kararı hisle değil ölçümle verin. Çalışan bir iş sırasında kartı beş saniyede bir şöyle izleyebilirsiniz:
nvidia-smi --query-gpu=utilization.gpu,memory.used,memory.total --format=csv -l 5Çıktıyı iki durumla okuyun. Bellek sürekli toplama yakınsa ve CUDA out of memory hatası alıyorsanız sorun VRAM’dir, daha büyük kart işe yarar. GPU kullanımı düşük ama bellek rahatsa kart veri bekliyordur; darboğaz vCPU sayısı veya disktir, daha büyük kart tek başına bir şey değiştirmez.
Şu sinyallerden biri varsa fiziksel sunucu teklifi alın:
- Küçültme ve 4-bit yöntemlerine rağmen model 4 GB’a sığmıyor.
- Tek bir eğitim koşusu saatlerden günlere uzuyor ve süre öngörülemiyor.
- Belirli bir sürücü ve CUDA sürümüne ihtiyacınız var.
- Birden fazla kart kullanmanız gerekiyor.
- Kişisel veri veya ticari sır içeren veri setiyle çalışıyorsunuz.
Kart yıl boyunca yoğun kullanılacaksa satın almak da seçenek hâline gelir; bu hesabı satın alma ve kiralama maliyet karşılaştırmamızda yapıyoruz. Taşıma tarafında işinizi kolaylaştıran şey, prototipi baştan sabit sürümlü bir Docker imajı olarak paketlemektir. Fiziksel sunucuda NVIDIA sürücüsü, CUDA Toolkit ve NVIDIA Container Toolkit kurulumunda destek alabilirsiniz.
Sahadan Not: Uzun bir eğitimi başlatmadan önce veri setinizdeki en uzun örneklerle tek batch’lik bir prova yapın. Dizi uzunluğu değişken olduğunda bellek tepe noktası ilk adımlarda değil, en uzun batch geldiğinde görülür ve iş saatler sonra durabilir. Aynı provada kontrol noktasının diske yazıldığını ve geri yüklenebildiğini de doğrulayın.
Sık Sorulan Sorular
Eğitim sırasında VRAM yetmezse ne olur?
İş genellikle CUDA out of memory hatasıyla durur. Önce batch boyutunu düşürün, karma hassasiyeti açın, gradyan biriktirme ve gradient checkpointing seçeneklerini deneyin. Bu ayarlar belleği rahatlatır ama eğitim süresini çoğu zaman uzatır. Model yine sığmıyorsa sorun ayarlarda değil kapasitededir ve daha yüksek VRAM’li bir yapılandırmaya geçmek gerekir.
Birden fazla GPU kullanınca VRAM toplanır mı?
Otomatik olarak toplanmaz. Veri paralel eğitimde her kart modelin bir kopyasını taşır, bu yüzden iki adet 24 GB kart size tek parça 48 GB vermez. Kazancınız daha büyük toplam batch ve daha kısa eğitim süresi olarak gelir. Modeli kartlara bölen yöntemler de vardır, ancak kurulumları ve kartlar arası iletişim yükleri ayrıca planlanmalıdır.
Eğitilmiş modeli servis etmek için eğitimdeki donanım gerekir mi?
Genellikle gerekmez. Servis aşamasında gradyan ve optimizer durumu kartta tutulmaz, model ayrıca kuantize edilebilir. Bu yüzden eğitimi yüksek VRAM’li bir sunucuda yapıp modeli daha küçük bir kartta sunmak yaygın bir yaklaşımdır. Gereken kapasiteyi eş zamanlı istek sayısı, üretilecek metin uzunluğu ve kabul edebileceğiniz gecikme belirler.
Eğitimde işlemci çekirdeği ne kadar önemli?
İşlemci veriyi okur, çözer, ön işler ve kartı besler. Çekirdek sayısı az kalırsa kart boşta bekler; bunu nvidia-smi çıktısında düşük GPU kullanımı olarak görürsünüz. Görüntü ve video veri setlerinde ön işleme yükü yüksektir, metin eğitimlerinde genellikle daha düşüktür. Kart başına kaç çekirdek gerektiğini kendi veri hattınızı ölçerek belirleyin.
Eğitim yarıda kesilirse ilerleme kaybolur mu?
Düzenli kontrol noktası (checkpoint) alıyorsanız kaybolmaz. Model ağırlıklarını, optimizer durumunu ve adım sayısını belirli aralıklarla NVMe diske yazın, eğitimi son kayıttan sürdürün. Aralığı, kaybetmeyi göze alabileceğiniz süreye göre seçin. Kayıtların bir kopyasını sunucu dışında tutmak, donanım arızası veya yanlışlıkla silme durumunda işinizi korur.
Hassas veriyle model eğitirken nelere dikkat etmeliyim?
Kişisel veri veya ticari sır içeren veri setlerinde donanımı paylaşmamak işinizi kolaylaştırır, ancak tek başına uyum sağlamaz. Erişim yetkilerini, diskteki şifrelemeyi, loglara düşen örnekleri ve veri saklama süresini planlayın. KVKK yükümlülükleriniz için hukuk danışmanınızla çalışın. Buradaki bilgiler teknik bilgilendirme amaçlıdır, hukuki görüş yerine geçmez.
Sonuç: Yapay Zeka Eğitimi İçin GPU Sunucu Kararı
Yapay zeka eğitimi için GPU sunucu arıyorsanız kararınız nettir: Model eğitecek veya ince ayar yapacaksanız VRAM’i iş yüküne göre seçilmiş fiziksel sunucuya gidin, 1–4 GB VRAM bu işlerin yeri değildir. Henüz kodunuzu doğruluyorsanız ya da küçük bir model servis edecekseniz GPU VDS ile düşük maliyetle başlayın, paketler arasında yükseltme yapın.
Yıllık alımlarda 10 ay öde, 12 ay kullan kampanyasından yararlanabilirsiniz. Fiziksel sunucu için WhatsApp veya teklif formundan iş yükünüzü iletmeniz yeterli; 7/24 Türkçe teknik destek ekibimiz kart, RAM ve disk seçiminde yanınızda olur.
GPU fiziksel sunucu
Modelinize uygun yapılandırmayı birlikte çıkaralım
Framework’ünüzü, model boyutunuzu ve eğitim takviminizi iletin. VRAM, RAM, disk ve kart adedini iş yükünüze göre belirleyip kalem kalem teklif hazırlayalım.
Önem Bilişim Teknik Ekibi
2019’dan beri hizmet veren, ETBİS kayıtlı bir sunucu ve yazılım hizmetleri şirketiyiz. GPU VDS, fiziksel sunucu ve barındırma hizmetlerimizde 7/24 Türkçe teknik destek sunuyoruz.
Son güncelleme: 9 Kasım 2026