 Ekonomik SSD Hosting
 VDS Kirala
 Ryzen VDS
 Discord VDS
 Sunucu Barındırma
 Fiziksel Sunucu
 Rust Server Kirala
 Minecraft Server Kirala
 CS2 Server Kirala
 Unturned Server Kirala
 MTA Server Kirala
 FiveM Server Kirala
 Garry's Mod Server Kirala
 Palworld Server Kirala
 Valheim Server Kirala
 Layer 7 Koruma
 Rust Plugin Paket
 Yazılım Hizmetleri
Otonom Sürüş ve Görüntü İşleme Projelerinde GPU Fiziksel Sunucu Kullanımı
Kamera verisinin hacmi, NVMe darboğazı, YOLO eğitimi için kart seçimi, sensör füzyonu ve simülasyon ile eğitimden TensorRT dağıtımına uzanan döngü; bilgisayarlı görü projeleri için altyapı planı.
İçindekiler
- Görüntü İşleme Sunucusu Hangi İşleri Üstlenir?
- Veri Hacmi Altyapıyı Nasıl Belirler?
- NVMe I/O Darboğazı Nasıl Önlenir?
- YOLO Eğitimi GPU’dan Neler İster?
- Model boyutunu nasıl seçmelisiniz?
- Sensör Füzyonu ve Simülasyon İçin Ne Planlanmalı?
- CUDA ve Docker Ortamı Nasıl Hazırlanır?
- Eğitimden TensorRT Dağıtımına Döngü Nasıl İşler?
- Dağıtım öncesinde hangi ölçümleri yapmalısınız?
- Hangi Yapılandırma Hangi Projeye Uyar?
- Sık Sorulan Sorular
- Görüntü boyutunu artırmak ne kadar VRAM ister?
- Çoklu GPU eğitim süresini doğrusal olarak kısaltır mı?
- TensorRT ile model eğitebilir miyim?
- GPU VDS üzerinde gerçek zamanlı nesne tespiti çalışır mı?
- Kamera görüntülerini eğitimde kullanırken nelere dikkat etmeliyim?
- Etiketleme araçlarını aynı sunucuda çalıştırabilir miyim?
- Sonuç: Görüntü İşleme Sunucusu Kararı
Bir görüntü işleme modelini büyütmek isteyen ekiplerin önce karşılaştığı sorun çoğu zaman kart değil, verinin kartın önüne yetişememesidir. Görüntü işleme sunucusu seçerken terabaytlarca kamera verisi, disk hızı ve kart belleği birlikte düşünülmelidir. GPU fiziksel sunucu kiralama seçeneklerinde bu üç kaynağı iş yükünüze göre ayarlayabilirsiniz. Yazının sonunda veri hacminizi hesaplayacak, NVMe darboğazını önleyecek ve projeniz için doğru VRAM ile kart sayısını bileceksiniz.
Kısa Cevap: Görüntü işleme sunucusunda kart belleği görüntü boyutu ve batch ile büyür, ancak eğitimi çoğu zaman NVMe hızı ve veri hattı yavaşlatır. Küçük YOLO projeleri 8–16 GB ile başlayabilir, büyük segmentasyon ve çok kameralı veri için 24–48 GB ve çoklu GPU gerekir.
Görüntü İşleme Sunucusu Hangi İşleri Üstlenir?
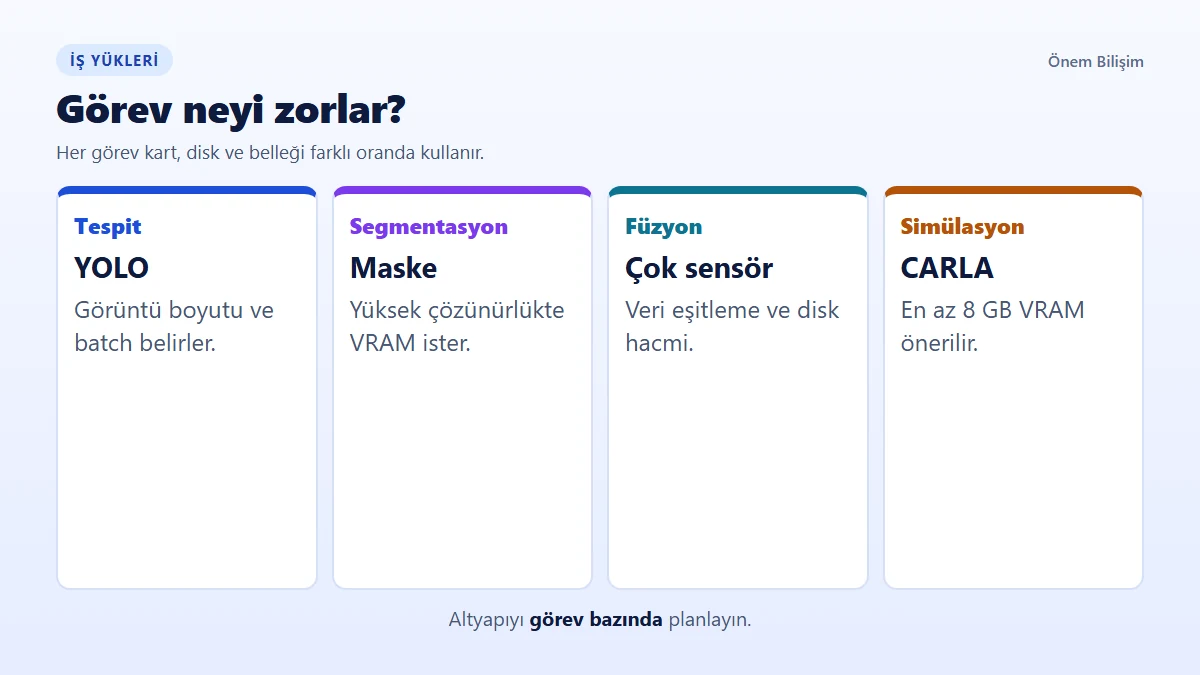
Görüntü işleme sunucusu; veri hazırlığı, nesne tespiti ve segmentasyon eğitimi, sensör füzyonu, simülasyon ve toplu çıkarım işlerini üstlenir. Bu işlerin hiçbiri aynı kaynağı aynı oranda kullanmaz. Bilgisayarlı görü GPU sunucu planlamasını bu yüzden görev bazında yapmak gerekir.
| Görev | Tipik araç | Belleği büyüten etken | Dikkat edilecek nokta |
|---|---|---|---|
| Nesne tespiti | YOLO | Görüntü boyutu, batch | Veri yükleyici hızı |
| Segmentasyon | Transformer tabanlı modeller | Yüksek çözünürlüklü maskeler | VRAM ve dizi başına bellek |
| Sensör füzyonu | Kamera ve LiDAR modelleri | Çok kanallı girdi | Veri eşitleme, disk hacmi |
| Simülasyon | CARLA | Sahne ve sensör sayısı | Kart hem işler hem çizer |
| Toplu çıkarım | TensorRT | Model boyutu | Kart mimarisine özel derleme |
Bu yazıda anlatılanlar altyapı planlamasıyla ilgilidir. Gerçek bir araçta kullanılacak sistemlerin güvenliği; ayrı doğrulama süreçleri, sertifikasyon ve saha testleriyle ele alınır ve hiçbir sunucu yapılandırması tek başına güvenli sürüş sağlamaz.
Veri Hacmi Altyapıyı Nasıl Belirler?
Veri hacmi altyapıyı belirler, çünkü kamera verisi kart belleğinden çok önce disk kapasitesini ve ağ süresini tüketir. Sıkıştırılmamış bir 1080p karenin boyutu 1920 × 1080 × 3 bayt, yani yaklaşık 6,2 MB’tır. Saniyede 30 kare kaydeden tek bir kamera yaklaşık 187 MB/s veri üretir.
Bu değer saatte yaklaşık 670 GB eder. Altı kameralı bir kurulumda ham veri saatte 4 TB’a yaklaşır. Video sıkıştırma bu rakamı büyük ölçüde düşürür, ancak eğitim için kareleri açtığınızda ya da etiketleme yaparken ham boyut yeniden gündeme gelir.
Planı üç alana bölün: Ham kayıt arşivi, etiketlenmiş eğitim seti ve eğitimin hızlı okuduğu çalışma kopyası. Yalnızca üçüncüsünün NVMe üzerinde durması gerekir. Veri aktarımı da süreye dahildir; 1 Gbps bir bağlantı teorik olarak saatte yaklaşık 450 GB taşıyabilir, 10 Gbps ise bunun on katını sağlar.
Plaka ve yüz içeren görüntüler kişisel veri kapsamına girebilir. Eğitim verisini toplamadan önce hukuki dayanağınızı belirleyin ve gerekli alanlarda anonimleştirme uygulayın.
NVMe I/O Darboğazı Nasıl Önlenir?
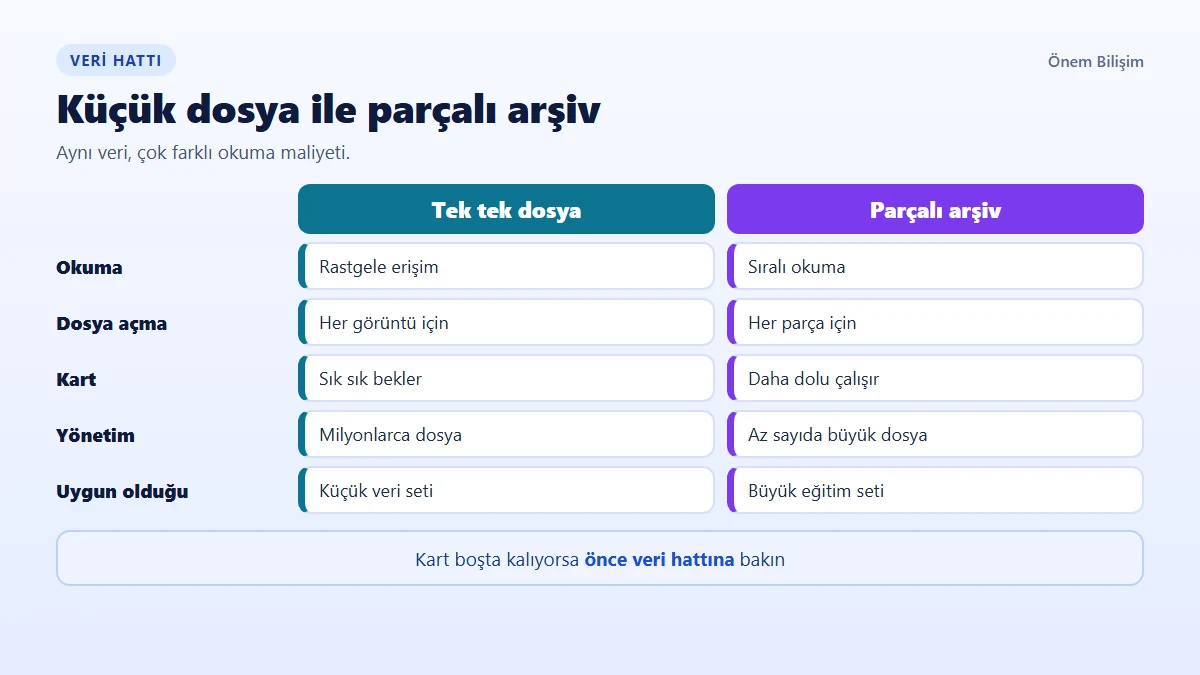
NVMe I/O darboğazı, veriyi büyük parçalı arşivlerde tutarak, ön işlemeyi hızlandırarak ve okunan veriyi önbelleğe alarak önlenir. Eğitim sırasında nvidia-smi çıktısında kart kullanımı sürekli düşüyorsa kart veri bekliyor demektir. Bu durumda kart değiştirmek hiçbir şeyi çözmez.
Basit bir hesap yapın: Her biri 300 KB olan JPEG’lerden saniyede 640 tanesini okumak için yaklaşık 192 MB/s sürekli okuma gerekir. Bu rakam tek bir eğitim için SATA SSD sınırına uzak görünse de milyonlarca küçük dosyayı açmanın maliyeti asıl sorunu yaratır. Disk türleri arasındaki farkı NVMe ve SSD karşılaştırması yazısında anlattık.
Milyonlarca küçük dosya yerine WebDataset veya benzeri biçimlerle veriyi büyük parçalara bölün. Sıralı okuma, rastgele küçük dosya erişiminden çok daha verimlidir. JPEG çözme işlemciyi dolduruyorsa NVIDIA DALI gibi GPU destekli veri yükleyicilerle bu yükü karta aktarabilirsiniz.
YOLO Eğitimi GPU’dan Neler İster?
YOLO eğitimi için kart belleği görüntü boyutuna ve batch değerine göre belirlenir; aynı batch ile çözünürlüğü iki katına çıkarmak bellek ihtiyacını yaklaşık dört katına yükseltir. Ultralytics eğitim belgesi çoklu GPU kullanımını device parametresiyle, otomatik batch seçimini ise batch=-1 ile sağlar. Bu otomatik ayar kart belleğinin yaklaşık %60’ını hedefler.
yolo train model=yolo26n.pt data=veri.yaml epochs=100 imgsz=640 device=0,1 batch=-1 cache=diskcache=disk önişlenmiş görüntüleri diske yazarak sonraki epoch’ları hızlandırır, cache=ram ise veri seti sistem belleğine sığıyorsa daha iyi sonuç verir. Çoklu GPU kullandığınızda her kart modelin kendi kopyasını taşır, bu yüzden daha büyük bir modeli sığdırmaz, batch’i ve hızı artırır.
Lisansı da erken kontrol edin. Ultralytics YOLO, AGPL-3.0 veya ücretli kurumsal lisansla sunulur; AGPL-3.0 koşullarında projenizin kaynak kodunu açmanız beklenir. Kapalı kaynak bir ürün geliştiriyorsanız kurumsal lisansı veya başka lisanslı bir modeli değerlendirin.
Eğitimde ayrıca artırma (augmentation) ayarlarının işlemci yükü yarattığını unutmayın. Mozaik gibi yoğun artırmalar kartı değil çekirdekleri zorlar. Sunucuda veri yükleyici işçi sayısını, işlemci kullanımına bakarak ayarlayın.
Model boyutunu nasıl seçmelisiniz?
Model boyutunu seçerken en küçük modelle başlayıp doğruluk hedefinize ulaşana kadar kademeli büyütün. Küçük modeller kartta daha az yer kaplar, daha hızlı eğitilir ve dağıtımda daha düşük gecikme verir. Büyük modele geçişin getirisi çoğu zaman verinizdeki eksikler giderildiğinde ortaya çıkar.
Uzun eğitimlerde kontrol noktalarının düzenli yazıldığından emin olun. Ultralytics yarım kalan bir eğitimi resume=True ile sürdürebilir. Kontrol noktalarını ayrı bir konuma da kopyalamak, disk arızasında haftalık bir emeğin kaybolmasını önler.
Sensör Füzyonu ve Simülasyon İçin Ne Planlanmalı?
Sensör füzyonu için çok kanallı veriyi zaman olarak eşitleyebilen bir veri hattı, simülasyon için ise hem çizim hem hesap yapabilen ayrılmış bir kart planlanmalıdır. Kamera ve LiDAR verileri farklı sıklıkta geldiğinden zaman damgaları doğru hizalanmadığında model hatalı ilişkiler öğrenir. Bu sorun donanımla değil, veri hattında çözülür.
CARLA hızlı başlangıç belgesi en az 8 GB VRAM’e sahip ayrılmış bir kart önerir, varsayılan olarak 2000 ve 2001 numaralı TCP portlarını kullanır. Simülatör kartı çizim için kullandığından aynı kartta eş zamanlı model eğitimi yapmak iki işi de yavaşlatır. Çoklu GPU kurulumda birini simülasyona, diğerini eğitime ayırmak daha verimlidir.
Simülasyonda elde edilen başarı gerçek dünyaya doğrudan aktarılmaz. Simülasyonu veri çeşitlendirme ve hızlı senaryo sınaması için kullanın; gerçek veriyle doğrulamadan sonuç çıkarmayın.
CUDA ve Docker Ortamı Nasıl Hazırlanır?
CUDA ve Docker ortamı; NVIDIA sürücüsü, Docker ve NVIDIA Container Toolkit kurularak hazırlanır ve kart erişimi kısa bir komutla doğrulanır. Önem Bilişim GPU fiziksel sunucularında bu üç bileşen için kurulum desteği alabilirsiniz. Kapsayıcı kullanmak, proje sürümlerini sunucudan bağımsız hale getirir.
sudo docker run --rm --runtime=nvidia --gpus all ubuntu nvidia-smiEğitim kapsayıcısı başlatırken veri dizinini bağlamayı ve paylaşımlı belleği artırmayı unutmayın. PyTorch veri yükleyicileri işçiler arasında veriyi paylaşımlı bellekle taşır; Docker’ın varsayılan değeri küçük kaldığında eğitim beklenmedik hatalarla durur.
docker run --rm --gpus all --shm-size=32g -v /veri:/veri egitim-imaji python train.pySürüm uyumunu da kayıt altına alın. CUDA Toolkit, PyTorch derlemesi ve sürücü sürümleri birlikte çalışmak zorundadır. Çalışan imajı etiketleyip saklamak, aylar sonra aynı sonucu üretmenin kolay yoludur.
Eğitimden TensorRT Dağıtımına Döngü Nasıl İşler?
Eğitimden dağıtıma döngü; eğitim, doğrulama, model dışa aktarma, TensorRT ile derleme ve hedef donanımda ölçüm adımlarından oluşur. TensorRT belgesine göre bu SDK, NVIDIA kartlarda çıkarımı optimize etmek içindir; eğitim için değildir. Yalnızca çıkarım aşamasında devreye girer.
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")
model.export(format="engine", quantize=16)
TensorRT motorları derlendikleri kart mimarisine özgüdür ve taşınabilir bir model biçimi olarak düşünülmemelidir. Motoru dağıtım yapacağınız kartta veya aynı mimari ve sürümle derleyin. INT8 nicemleme kullanıyorsanız kalibrasyonu da hedef cihazda yapın, ardından doğruluğu yeniden ölçün.
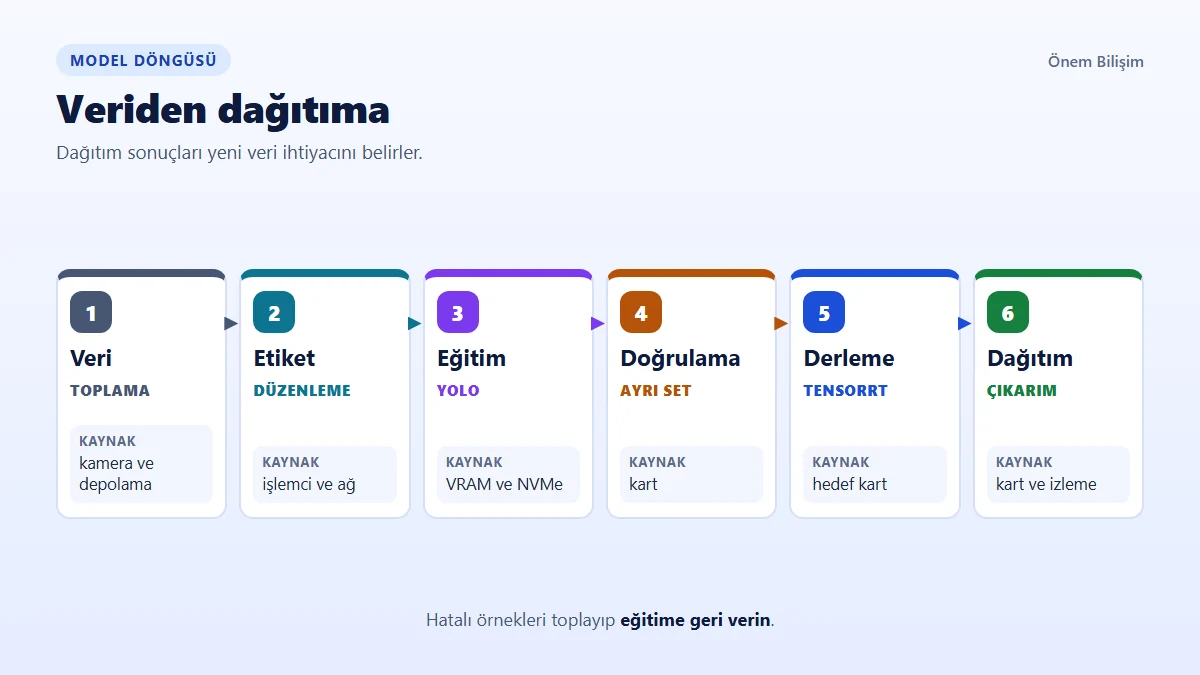
Dağıtımdan gelen hatalı örnekleri düzenli toplayıp eğitim setine eklemek döngüyü tamamlar. Modelin en çok hata yaptığı sahneleri etiketlemek, rastgele yeni veri eklemekten daha çok fayda sağlar. Görsel benzerlik gibi başka bilgisayarlı görü uygulamalarında kullanılan yöntemleri e-ticarette görsel arama yazısında bulabilirsiniz.
Dağıtım öncesinde hangi ölçümleri yapmalısınız?
Dağıtım öncesinde doğruluk, sınıf bazlı duyarlılık ve kare başına gecikme birlikte ölçülmelidir. Genel mAP değeri iyi görünse de nadir ama önemli bir sınıf düşük performans gösterebilir. Bu yüzden sonuçları gece, yağmur veya kalabalık sahne gibi koşullara ayırarak inceleyin.
Gecikmeyi de ortalamayla değil, yüksek yüzdelik değerlerle izleyin. Nicemleme sonrasında doğruluk düşebileceğinden aynı doğrulama setini TensorRT motoruyla yeniden çalıştırın. Sonuçları model sürümüyle birlikte kaydetmek, hangi değişikliğin neyi iyileştirdiğini görmenizi sağlar.
Hangi Yapılandırma Hangi Projeye Uyar?
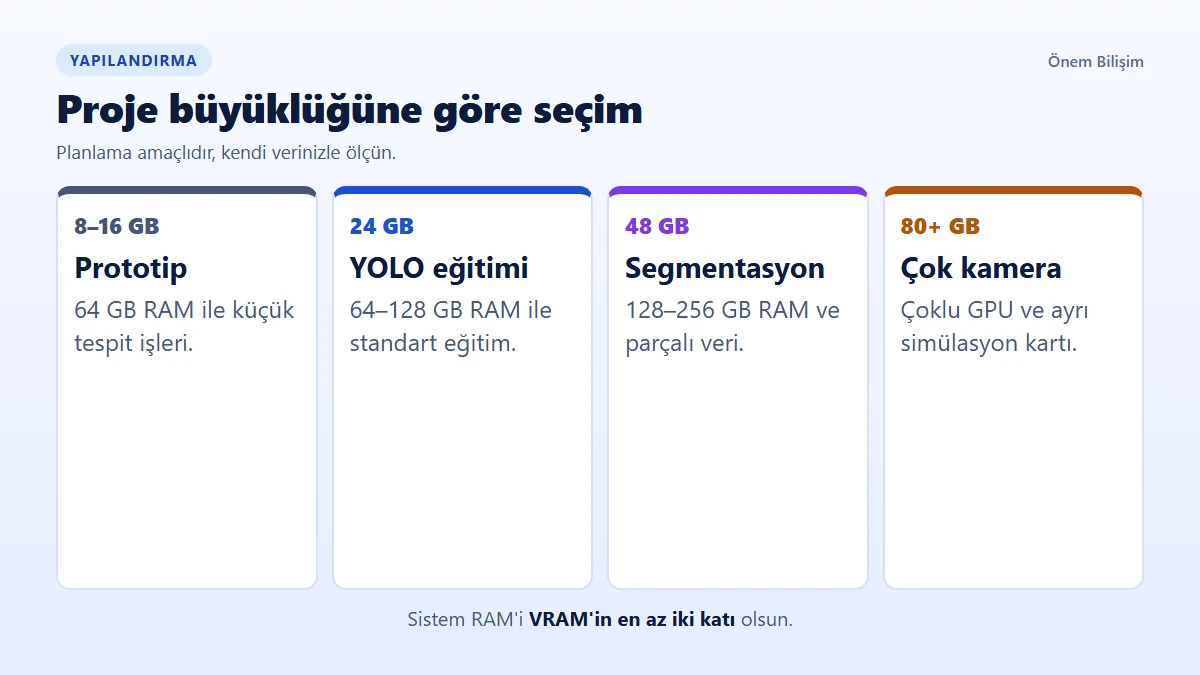
Tek kameralı küçük tespit projeleri için 8–16 GB, standart YOLO eğitimi ve küçük segmentasyon için 24 GB, çok kameralı veri ve yüksek çözünürlüklü segmentasyon için 48 GB ve üzeri doğru başlangıçtır. Aşağıdaki eşleştirme planlama amaçlıdır. Kart adedi ve güncel kart listesi teklif aşamasında paylaşılır.
| Proje | VRAM | Sistem RAM’i | Not |
|---|---|---|---|
| Küçük tespit, prototip | 8–16 GB | 64 GB | Tek çalışma kopyası NVMe’de |
| YOLO eğitimi, küçük segmentasyon | 24 GB | 64–128 GB | Veri hattını önceden ölçün |
| Yüksek çözünürlüklü segmentasyon | 48 GB | 128–256 GB | Parçalı arşiv kullanın |
| Çok kameralı füzyon, simülasyon | 80 GB ve üzeri veya çoklu GPU | 256 GB ve üzeri | Eğitim ve simülasyon için ayrı kart |
Bellek hesabınız sınıra yakın çıkıyorsa yüksek VRAM’li fiziksel sunucu seçerken bir kademe yukarıyı değerlendirin. Daha büyük dil modelleriyle görüntü verisini birleştirmeyi düşünüyorsanız LLM ince ayarı rehberimizde bellek hesabını bulabilirsiniz.
Hazır bir modeli demo olarak sunmak veya hafif çıkarım yapmak için aylık 1.500 ₺’den başlayan GPU VDS yeterli olabilir. Bu paketlerde 1–4 GB VRAM ile küçük modeller çalışır, eğitim için uygun değildir ve işlem birimleri zaman paylaşımlıdır. Prototipi burada gösterip eğitim ve büyük veri için fiziksel sunucuya geçin; karar mantığını VDS ile fiziksel sunucu kararı yazısında özetledik.
Sahadan Not: Yeni bir sunucuda ilk ölçümü modelle değil, yalnızca veri yükleyiciyle yapın. Modeli çağırmadan veri setini bir epoch boyunca okuyup saniyede kaç görüntü geldiğini kaydedin. Bu değer modelin kartta işleyebildiği hızın altındaysa, eğitim ayarlarıyla uğraşmadan önce veri hattını düzeltmeniz gerekir.
Sık Sorulan Sorular
Görüntü boyutunu artırmak ne kadar VRAM ister?
Görüntü boyutunu iki katına çıkarmak piksel sayısını dört katına çıkarır, bu yüzden kart belleği ihtiyacı da aşağı yukarı aynı oranda büyür. Model mimarisi ve batch değeri sonucu değiştirir. Küçük bir batch ile hedef boyutta deneme yapıp nvidia-smi ile tepe belleği izleyin. Ardından batch değerini bu ölçüme göre artırmak daha güvenlidir.
Çoklu GPU eğitim süresini doğrusal olarak kısaltır mı?
Çoğu durumda tam doğrusal bir kısalma beklenmez. Kartlar arası senkronizasyon, veri yükleyici hızı ve disk okuma sınırları toplam kazancı azaltır. Veri hattı zaten darboğazsa ikinci kart çok az fark yaratır. Önce tek kartta veri hattını doyurup kullanımı ölçün, ardından ikinci kartla aynı testi tekrarlayarak gerçek kazancı kendi iş yükünüzde görün.
TensorRT ile model eğitebilir miyim?
Hayır, TensorRT eğitilmiş modellerin NVIDIA kartlarda çıkarım için optimize edilmesini sağlar. Eğitimi PyTorch gibi bir çerçeveyle yapar, sonra modeli dışa aktarırsınız. Derlenen motor belirli bir kart mimarisine ve TensorRT sürümüne bağlı olduğundan farklı bir kartta yeniden derlemeniz gerekebilir. Bu yüzden dışa aktarma adımını dağıtım planınızın parçası yapın.
GPU VDS üzerinde gerçek zamanlı nesne tespiti çalışır mı?
Küçük modeller ve düşük çözünürlüklerle çalışabilir, ancak gerçek zamanlı performans paylaşımlı kart nedeniyle yoğun saatlerde değişebilir. 1–4 GB VRAM’e sığan küçük bir model seçin ve kendi video akışınızla kare başına süreyi ölçün. Sıkı gecikme hedefleri ya da çok kameralı bir kurulum varsa kartın tamamını kullanmak daha güvenilir bir sonuç verir.
Kamera görüntülerini eğitimde kullanırken nelere dikkat etmeliyim?
Görüntülerde yüz veya plaka varsa bunlar kişisel veri kapsamına girebilir. Veri toplama amacınızı ve hukuki dayanağınızı belirleyin, gerekli yerlerde bulanıklaştırma veya anonimleştirme uygulayın ve erişimi sınırlandırın. Saklama süresini baştan belirlemek de önemlidir. Kurumunuzun hukuk birimiyle birlikte hareket etmek, proje ilerledikten sonra çıkabilecek sorunları önler.
Etiketleme araçlarını aynı sunucuda çalıştırabilir miyim?
Evet, CVAT benzeri etiketleme araçları sunucuda çalıştırılabilir, ancak bu araçlar kart yerine çoğunlukla işlemci, disk ve ağ kullanır. Eğitim sırasında etiketleme yapılıyorsa iki iş disk erişiminde çakışabilir. Web arayüzünü dışarı açıyorsanız erişimi VPN veya IP kısıtlamasıyla koruyun. Küçük ekiplerde aynı sunucu yeterli olur, büyük ekiplerde ayrı sunucu daha düzenlidir.
Sonuç: Görüntü İşleme Sunucusu Kararı
Görüntü işleme sunucusu seçiminde önce veri hattınızı ölçün, ardından görüntü boyutu ve batch değerine göre VRAM’i belirleyin. Standart YOLO eğitimi için 24 GB, yüksek çözünürlüklü segmentasyon ve çok kameralı veri için 48 GB ve üzeri ile NVMe çalışma alanı planlayın, simülasyon için ayrı kart ayırın.
Kamera sayınızı ve veri hacminizi WhatsApp veya teklif formundan iletin. Yıllık alımlardaki 10 ay öde, 12 ay kullan avantajını teklif sırasında sorabilir, 7/24 Türkçe destek ekibimizden kurulum için yardım alabilirsiniz.
GPU fiziksel sunucu
Veri setinize uygun kartı ve diski planlayalım
Kamera sayınızı, veri hacminizi ve model hedefinizi iletin; kart adedi, NVMe kapasitesi ve RAM yapılandırmasını projenize özel teklifle netleştirelim.
Önem Bilişim Teknik Ekibi
2019’dan beri hizmet veren, ETBİS kayıtlı bir sunucu ve yazılım hizmetleri şirketiyiz. GPU VDS, fiziksel sunucu ve barındırma hizmetlerimizde 7/24 Türkçe teknik destek sunuyoruz.
Son güncelleme: 9 Kasım 2026