 Ekonomik SSD Hosting
 VDS Kirala
 Ryzen VDS
 Discord VDS
 Sunucu Barındırma
 Fiziksel Sunucu
 Rust Server Kirala
 Minecraft Server Kirala
 CS2 Server Kirala
 Unturned Server Kirala
 MTA Server Kirala
 FiveM Server Kirala
 Garry's Mod Server Kirala
 Palworld Server Kirala
 Valheim Server Kirala
 Layer 7 Koruma
 Rust Plugin Paket
 Yazılım Hizmetleri
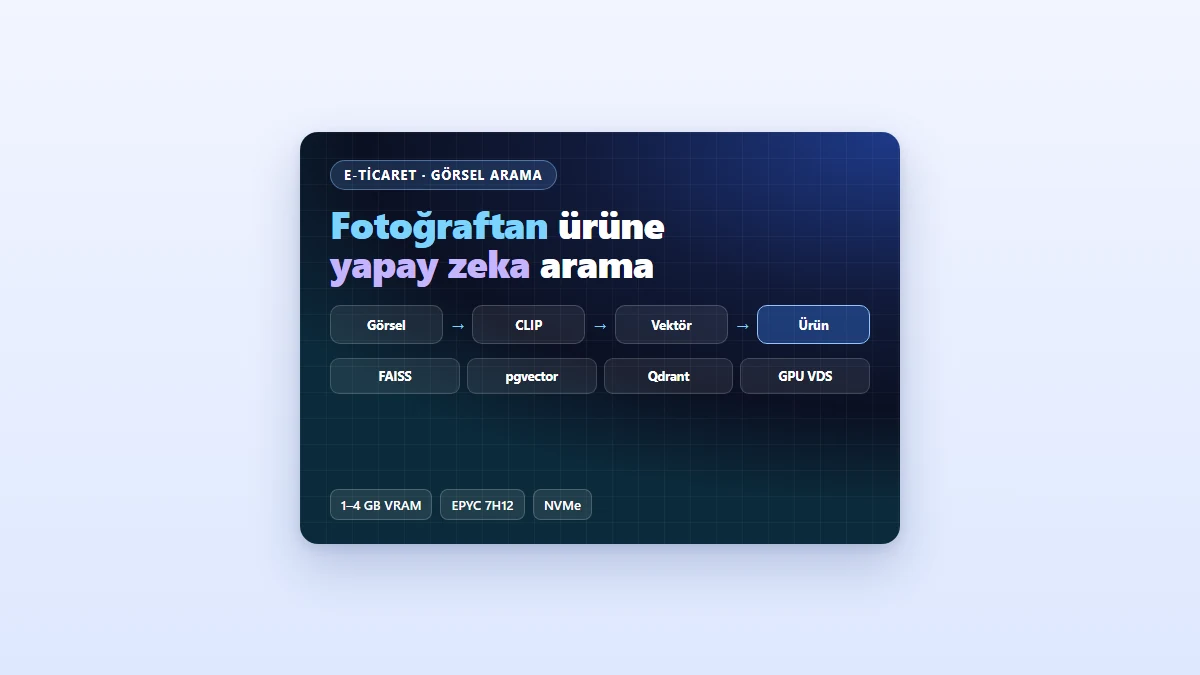
E-Ticaret İçin Görsel AI Arama Algoritmalarını GPU VDS Üzerinde Çalıştırmak
CLIP ile görselden embedding üretimi, FAISS ve pgvector ile benzer ürün araması, 1–4 GB VRAM'in hangi modellere yettiği ve büyük kataloglarda indeksleme mimarisi; kısa Python örneğiyle.
İçindekiler
- E-Ticaret Görsel Arama Yapay Zeka Sistemi Nasıl Çalışır?
- Hangi Adım GPU, Hangi Adım İşlemci Kullanır?
- CLIP Modeli 1–4 GB VRAM’e Nasıl Sığar?
- Vektör Veritabanı Nasıl Seçilir?
- HNSW ayarları nasıl seçilir?
- Python ile Görselle Ürün Arama Nasıl Kurulur?
- Büyük Katalog Nasıl İndekslenir?
- İndeksi VDS’e taşırken nelere dikkat edilmeli?
- Hangi Paket Hangi Kataloğa Uyar?
- Sık Sorulan Sorular
- Görsel arama için GPU şart mıdır?
- Yeni ürün eklendiğinde indeks yeniden oluşturulur mu?
- CLIP ticari projelerde kullanılabilir mi?
- Müşterinin yüklediği fotoğrafları saklamalı mıyım?
- Görsel arama sonucu nasıl iyileştirilir?
- Sistem aynı anda kaç sorguya yanıt verir?
- Sonuç: E-Ticaret Görsel Arama Yapay Zeka Altyapısı Kararı
Müşteriniz bir fotoğrafı yükleyip benzer ürünü bulmak istediğinde metin araması çaresiz kalır, çünkü kişi aradığı şeyin adını bile bilmeyebilir. E-ticaret görsel arama yapay zeka sistemleri bu boşluğu ürün görsellerini sayısal vektörlere çevirerek kapatır. Küçük ve orta ölçekli kataloglarda bu işi NVIDIA vGPU destekli VDS üzerinde çalıştırabilirsiniz. Yazının sonunda hangi adımın kartta, hangisinin işlemcide çalıştığını, kataloğunuza hangi paketin yettiğini ve kurulumu nereden başlatacağınızı bileceksiniz.
Kısa Cevap: Görsel aramada kart yalnızca embedding üretir; vektör araması çoğunlukla işlemcide ve RAM’de çalışır. CLIP ViT-B/32 gibi küçük bir model 1–2 GB VRAM ile sorgu yanıtlayabilir. Darboğaz çoğu zaman RAM’dir: 512 boyutlu 1 milyon ürün yaklaşık 2 GB ham vektör tutar, büyük ilk indeksleme ise fiziksel sunucuda yapılabilir.
E-Ticaret Görsel Arama Yapay Zeka Sistemi Nasıl Çalışır?
E-ticaret görsel arama yapay zeka sistemi, ürün görsellerini vektörlere çevirip sorgu görseline en yakın vektörleri bularak çalışır. Bu vektörlere embedding denir ve benzer içeriğe sahip görseller vektör uzayında birbirine yakın düşer. Tersine görsel arama da, benzer ürün önerisi de aynı temele dayanır.
Sistem iki ayrı akıştan oluşur. Çevrimdışı akışta katalogdaki her görsel bir kez işlenir ve vektörler bir indekste saklanır. Çevrimiçi akışta ise müşterinin görseli vektöre çevrilir, indekste en yakın ürünler bulunur ve stok ile kategori filtreleri uygulanarak sonuç döndürülür.
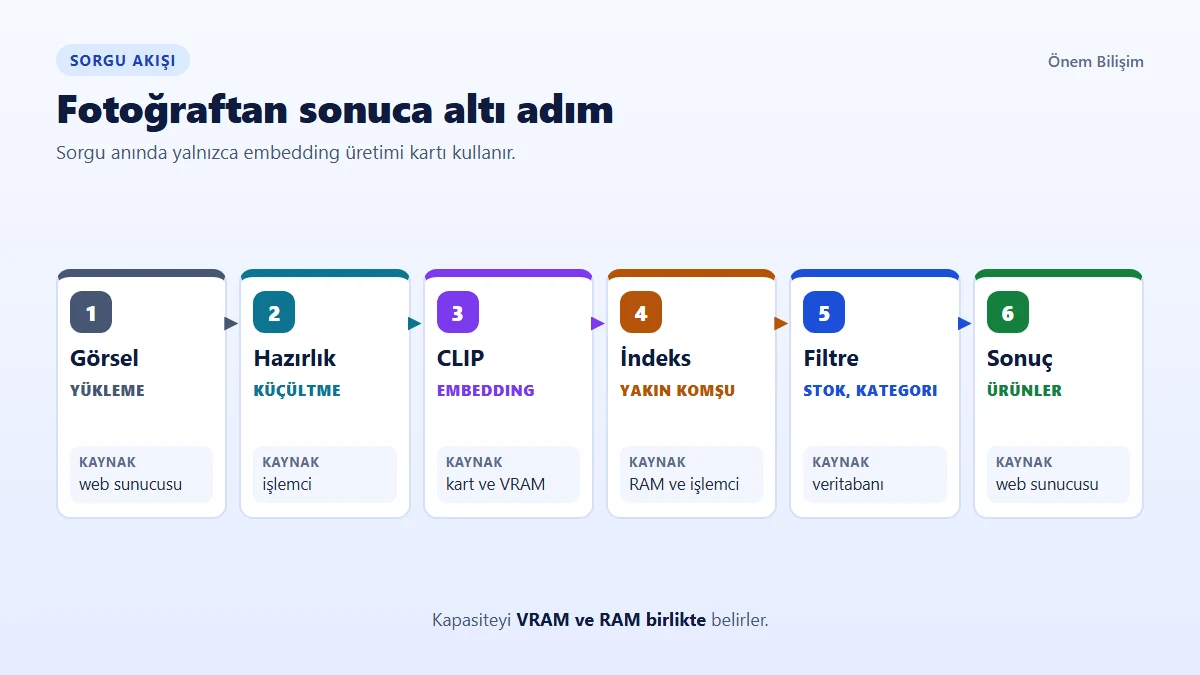
OpenAI CLIP, görselleri ve metinleri aynı vektör uzayına yerleştiren açık kaynaklı bir modeldir. Bu özellik sayesinde aynı indeks üzerinde hem fotoğrafla hem de “kırmızı deri çanta” gibi bir metinle arama yapabilirsiniz. Benzer bir görsel benzerlik mantığı büyük ölçekte görüntü işleme projelerinde de kullanılır.
Hangi Adım GPU, Hangi Adım İşlemci Kullanır?
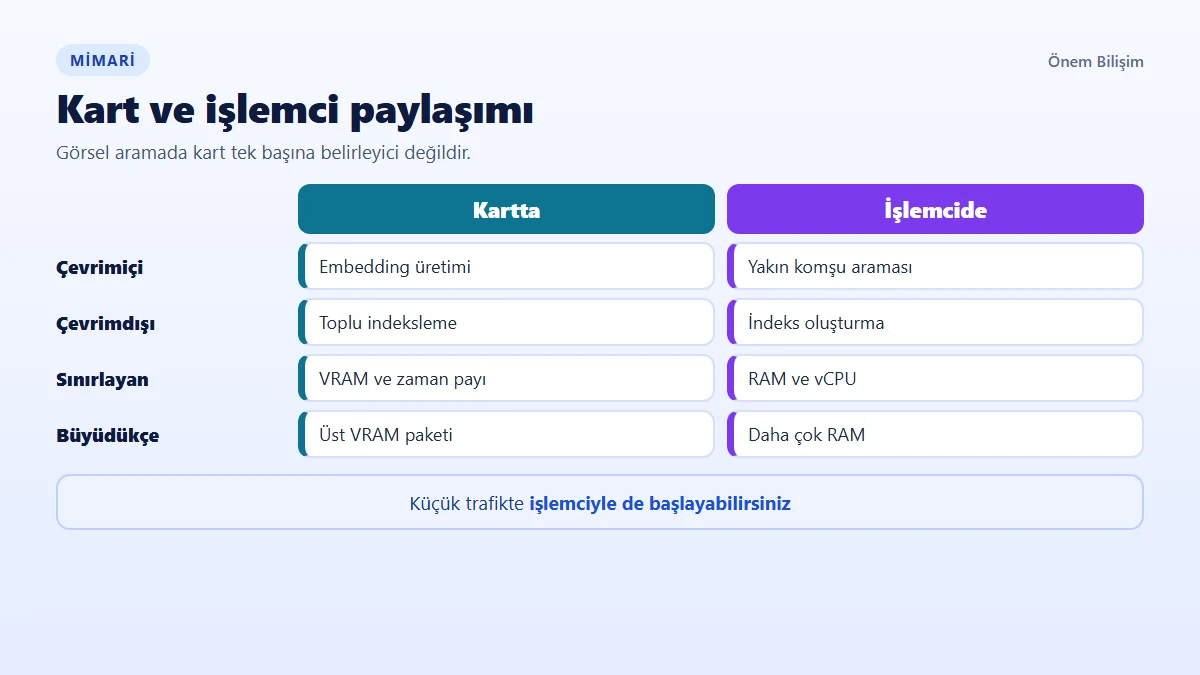
Görsel aramada GPU yalnızca embedding üretir; yakın komşu araması, filtreleme ve web sunumu işlemcide ve RAM’de çalışır. Bu yüzden GPU VDS için kart kadar vCPU ve RAM miktarı da belirleyicidir. EPYC 7H12 işlemcinin 8 kanal DDR4 bellek altyapısı vektör indeksinin bellekte taranmasında işe yarar.
| Adım | Çalıştığı yer | Sınırlayan kaynak |
|---|---|---|
| Sorgu görselini küçültme | İşlemci | vCPU |
| Embedding üretimi | Kart | VRAM, kart kullanımı |
| Yakın komşu araması | İşlemci, RAM | RAM, vCPU |
| Filtreleme, sıralama | İşlemci, veritabanı | vCPU, disk |
| Toplu katalog indeksleme | Kart | Kart süresi, veri okuma |
Bir uyarı: Küçük trafikli bir mağazada embedding üretimi işlemcide de çalışabilir. Saniyeler içinde yanıt yeterliyse GPU’suz başlamak mantıklıdır. GPU’nun karşılığını veren durum, eş zamanlı sorgular arttığında yanıt süresinin kısa kalması ve yeni ürünlerin hızla indekslenmesidir.
CLIP Modeli 1–4 GB VRAM’e Nasıl Sığar?
CLIP ViT-B/32 yaklaşık 151 milyon parametreyle 1 GB VRAM’e sığar, daha büyük modeller ise 2–4 GB gerektirir. Hesap basittir: 16-bit (FP16) parametre başına 2 bayt eder. Model ağırlıklarına batch ve çalışma zamanı belleğini de eklemeniz gerekir.
| Model | Yaklaşık parametre | FP16 ağırlık | Önerilen paket |
|---|---|---|---|
| CLIP ViT-B/32 | 151 milyon | 0,3 GB | Başlangıç, Standart, Plus (1 GB) |
| CLIP ViT-L/14 | 428 milyon | 0,9 GB | Pro (2 GB) |
| OpenCLIP ViT-H/14 | 986 milyon | 2 GB | Ultra (4 GB) |
Değerler yaklaşıktır ve vGPU profilinin ayırdığı bellek tamamen modele kalmaz. Büyük modeller daha iyi benzerlik sonucu verebilir, ancak vektör boyutları da değişebildiği için indeks belleğini artırır. Kendi ürün görsellerinizle küçük bir karşılaştırma yapıp yetiyorsa ViT-B/32’de kalın.
Önem Bilişim paketleri ve fiyatları bölümünde 1 GB ile 4 GB arasındaki seçenekleri görebilirsiniz. Kartın işlem birimleri zaman paylaşımlı olduğundan yoğun saatlerde yanıt süreniz değişebilir. Sorgu gecikmenizi ortalama olarak değil, yüzde 95’lik dilim gibi yüksek yüzdelik değerlerle izleyin.
Türkçe metin sorguları için dikkat edilmesi gereken bir nokta vardır. Temel CLIP modeli İngilizce metinle eğitilmiştir. Çok dilli CLIP metin modeli Türkçe dahil 50’den fazla dilde metni aynı görsel uzaya eşler ve görselleri yine ViT-B/32 ile kodlar.
Vektör Veritabanı Nasıl Seçilir?
Vektör veritabanı seçimi katalog boyutuna ve mevcut altyapınıza göre yapılır: Küçük projede FAISS, PostgreSQL kullanıyorsanız pgvector, filtre ve ölçek için Qdrant iyi başlangıçlardır. Üç seçenek de açık kaynaklıdır. Asıl fark, yönetim yükü ile filtreleme yeteneklerindedir.
| Seçenek | Uygun olduğu durum | Dikkat edilecek nokta |
|---|---|---|
| FAISS | Tek servis, basit gereksinim | Filtre ve kalıcılığı siz yazarsınız |
| pgvector | PostgreSQL kullanan mağazalar | HNSW indeksinde en çok 2.000 boyut |
| Qdrant | Yoğun filtreli, büyüyen kataloglar | Ayrı servis yönetimi gerekir |
Bellek hesabını önceden yapın. 512 boyutlu bir vektör 32-bit sayılarla 2.048 bayt eder; 100 bin ürün yaklaşık 205 MB, 1 milyon ürün yaklaşık 2 GB ham vektör demektir. HNSW gibi grafik tabanlı indeksler bunun üzerine ek bellek ister, bu nedenle hesapladığınız değere bir pay eklemelisiniz.
pgvector belgesine göre kosinüs araması <=> operatörü ile yapılır ve HNSW indeksi tek satırla oluşturulur:
CREATE EXTENSION IF NOT EXISTS vector;
CREATE TABLE urun_vektor (urun_id bigint PRIMARY KEY, embedding vector(512));
CREATE INDEX ON urun_vektor USING hnsw (embedding vector_cosine_ops);

SELECT urun_id FROM urun_vektor ORDER BY embedding <=> $1 LIMIT 20;
HNSW ayarları nasıl seçilir?
HNSW ayarlarında bellek, indeks oluşturma süresi ve doğruluk arasında denge kurulur. pgvector’de m varsayılanı 16, ef_construction varsayılanı 64 ve sorgu tarafındaki hnsw.ef_search varsayılanı 40’tır. Değerleri artırmak doğruluğu yükseltir, ancak indeks belleğini ve sorgu süresini de büyütür.
Önce varsayılan değerlerle ölçüm yapın. Tam tarama sonuçlarıyla karşılaştırarak kaçırılan ürün oranını çıkarın, yetersizse hnsw.ef_search değerini artırın. Sorgu tarafındaki bu ayar indeksi yeniden kurmadan değiştirilebildiği için ilk denenecek parametredir.
Stok dışı ürünleri sonuçtan elemek gerekiyorsa filtrenin indeks aramasından sonra uygulandığını unutmayın. Sıkı filtrelerde döndürülen sonuç sayısı beklediğinizden az kalabilir; bu durumda arama derinliğini artırın ya da filtre destekli bir motor kullanın.
Python ile Görselle Ürün Arama Nasıl Kurulur?
Python ile görselle ürün arama; görsel modeliyle vektör üretmek, FAISS’e eklemek ve sorgu vektörünü aratmak olmak üzere üç adımda kurulur. Aşağıdaki örnek metinle arama da yapabilmeniz için çok dilli modeli kullanır. Vektörler normalize edildiği için iç çarpım kosinüs benzerliğine eşittir.
from PIL import Image
from sentence_transformers import SentenceTransformer
import faiss
import numpy as np

gorsel_modeli = SentenceTransformer("clip-ViT-B-32")
metin_modeli = SentenceTransformer("sentence-transformers/clip-ViT-B-32-multilingual-v1")

dosyalar = ["urun1.jpg", "urun2.jpg", "urun3.jpg"]
vektorler = gorsel_modeli.encode(
    [Image.open(d) for d in dosyalar],
    batch_size=32,
    normalize_embeddings=True,
)

indeks = faiss.IndexFlatIP(vektorler.shape[1])
indeks.add(np.asarray(vektorler, dtype="float32"))

sorgu = metin_modeli.encode(["kırmızı deri çanta"], normalize_embeddings=True)
skorlar, siralar = indeks.search(np.asarray(sorgu, dtype="float32"), k=2)
print([dosyalar[i] for i in siralar[0]])
IndexFlatIP tüm vektörleri tarar, bu yüzden küçük kataloglarda tam doğru sonuç verir. Ürün sayısı artınca FAISS içindeki IndexHNSWFlat gibi yaklaşık indekslere geçin. Bu betik yalnızca bir başlangıçtır; üretimde indeksi diske kaydetme, güncelleme ve hata yönetimi de gerekir.
Mağazanız ayrı bir sunucudaysa görsel aramayı ayrı bir servis olarak kurup e-ticaret hosting altyapınızla yalnızca API üzerinden konuşturun. Böylece kart ağırlıklı iş yükü mağazanın ödeme ve sayfa performansını etkilemez.
Büyük Katalog Nasıl İndekslenir?
Büyük katalogda ilk indeksleme tek seferlik yoğun bir iştir, bu yüzden kartın tamamını kullanan bir sunucuda yapılıp sonuçta çıkan indeks VDS’e taşınabilir. Sorgu anı yükü küçüktür, ama yüzbinlerce görseli işlemek saatler sürebilir. Bu iş paylaşımlı kartta hem uzar hem de canlı sorguları yavaşlatır.
Süreyi tahmin etmek için örnek bir bin görseli işleyip saniyede kaç görsel geçtiğini ölçün. Ürün sayısını bu değere bölerek kaba bir toplam süre elde edersiniz. Bu süre gecelik bakım penceresini aşıyorsa ilk indekslemeyi kartın tamamı size ayrılan GPU sunucu üzerinde planlayın.
Modeli kendi ürünlerinizle ince ayarlamak istediğinizde de aynı sunucu kullanılır. Bu iş VDS paketlerinin kapsamında değildir; VRAM ve yöntem hesabı için LLM ince ayarı rehberimize benzer bir yaklaşım uygulayabilirsiniz. Yeni eklenen ürünler için ise ilk indekslemeyi tekrarlamaya gerek yoktur, vektörleri artımlı olarak ekleyin.
Aynı VDS üzerinde başka GPU işleri çalıştırıyorsanız kart belleğini paylaştığınızı hesaba katın. Örneğin canlı yayın transcoding kodlamayla aynı karta binerse iki servis de bellek ve işlem payı için yarışır. Kart seçiminde dikkat edilecek ayrıntılar için GPU kiralama kontrol listesine bakabilirsiniz.
İndeksi VDS’e taşırken nelere dikkat edilmeli?
İndeksi VDS’e taşırken embedding üreten model, ön işleme adımları ve vektör boyutu aynı kalmalıdır. Fiziksel sunucuda bir sürümle üretilen vektörleri başka bir modelin sorgularıyla aratmak anlamsız sonuçlar verir. Model adını ve sürümünü indeksle birlikte kaydedin.
İndeksi dosya olarak aktardıktan sonra birkaç bilinen sorguyla iki sunucunun aynı sonuçları döndürdüğünü doğrulayın. Canlı geçişi eski indeksi silmeden yapın; yeni indeks sorunsuz çalıştığında trafiği yönlendirip eskisini kaldırın.
Hangi Paket Hangi Kataloğa Uyar?
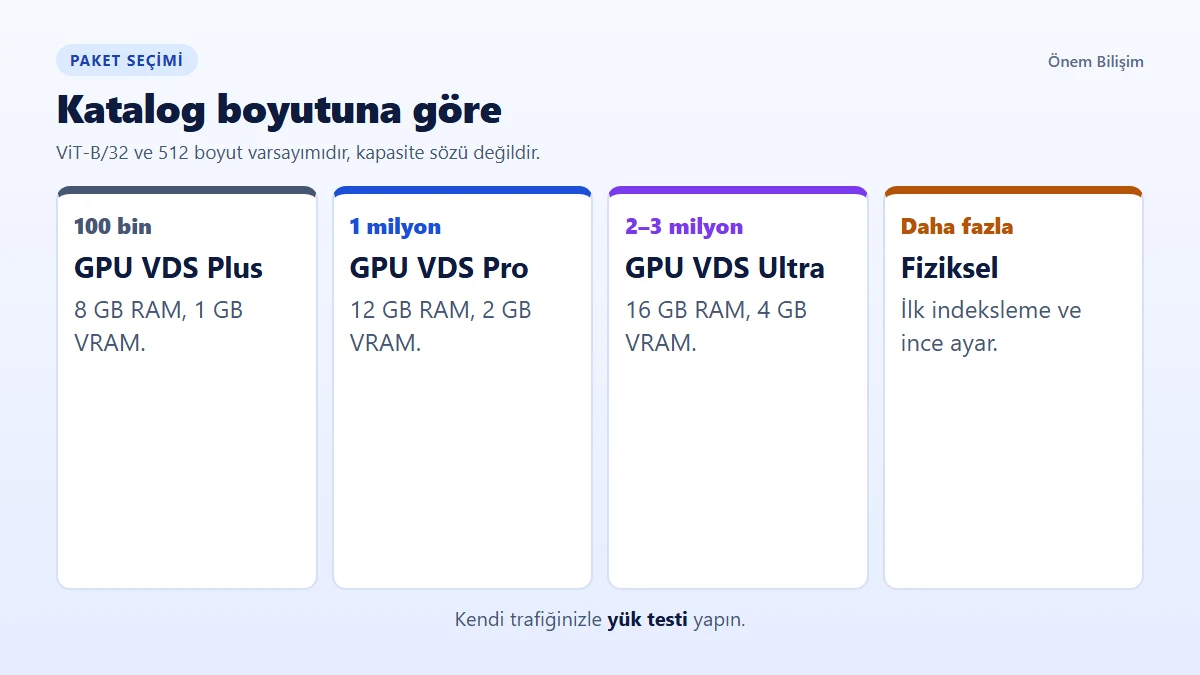
100 bin ürüne kadar Plus, 1 milyon civarında Pro, birkaç milyon ürüne kadar Ultra ve daha büyük kataloglarda fiziksel sunucu doğru başlangıçtır. Aşağıdaki eşleştirme ViT-B/32 ve 512 boyutlu vektör varsayımına dayanır, kapasite taahhüdü değildir. Trafiğiniz yüksekse paketi yukarı alın.
| Katalog boyutu | Ham vektör belleği | Başlangıç paketi | Dikkat edilecek nokta |
|---|---|---|---|
| 100 bin ürüne kadar | Yaklaşık 0,2 GB | GPU VDS Plus (8 GB RAM) | İşlemciyle de denenebilir |
| 1 milyon ürün civarı | Yaklaşık 2 GB | GPU VDS Pro (12 GB RAM) | HNSW payını ekleyin |
| 2–3 milyon ürün | 4–6 GB | GPU VDS Ultra (16 GB RAM) | Sistem belleğini izleyin |
| Daha büyük katalog, ince ayar | Değişken | Fiziksel sunucu | İlk indeksleme burada yapılır |
Ürün görsellerini kullanıcı yüklüyorsa sunucu tarafında dosya boyutunu ve türünü sınırlayın, istek sayısına hız sınırı koyun ve API’yi mağazanın yönetim paneliyle aynı adresten yayınlamayın. Kart ağırlıklı bir uç noktaya gelen kötü niyetli istekler, küçük bir pakette hizmeti kolayca yavaşlatabilir.
Disk tarafını da hesaplayın. Paketlerdeki 35–50 GB NVMe; işletim sistemi, model dosyaları ve indeks için yeterlidir, ama ürün görsellerinin kendisini burada tutmanız gerekmez. Görselleri mağazanızdan veya nesne depolamadan okuyun, sunucuda yalnızca vektörleri ve ürün kimliklerini saklayın.
Kurulumu kendiniz yapmak istemiyorsanız bu sistemi sizin için kuralım. Model seçimi, indeksleme ve mağaza entegrasyonu projenize göre planlanır.
Sahadan Not: Canlıya almadan önce kataloğunuzdan gerçek sorgularla küçük bir değerlendirme seti oluşturun. Her sorgu için doğru ürünlerin ilk sıralarda gelip gelmediğini ölçün. Beyaz arka planlı ürün görselleri ile müşterinin telefonla çektiği karanlık fotoğraflar çok farklı davranır; test setinde ikisini de bulundurun.
Sık Sorulan Sorular
Görsel arama için GPU şart mıdır?
Şart değildir. Trafiği düşük bir mağazada CLIP işlemcide de çalışabilir, sorgu başına birkaç yüz milisaniyeyi veya daha uzun süreyi kabul ediyorsanız GPU’suz başlayabilirsiniz. GPU, eş zamanlı sorgular arttığında ya da yeni ürünler sık indekslendiğinde gerçek fark yaratır. Önce kendi trafiğinize benzer bir yükle işlemcide ölçüm yapın.
Yeni ürün eklendiğinde indeks yeniden oluşturulur mu?
Hayır, çoğu indeks türünde yeni vektörleri artımlı olarak eklersiniz. Ürün eklendikçe embedding üretip indekse yazmak yeterlidir. Silinen ve sık değişen ürünlerin birikmesi zamanla indeksin kalitesini düşürebildiğinden periyodik olarak yeniden oluşturmayı planlayın. Yeniden oluşturmayı düşük trafikli saatlerde, ayrı bir indeks hazırlayıp geçiş yaparak gerçekleştirin.
CLIP ticari projelerde kullanılabilir mi?
OpenAI CLIP deposu MIT lisanslıdır, ancak model kartındaki kullanım notlarını da okumanız gerekir. Farklı bir ön eğitimli model seçerseniz lisansı o modelin kartından ayrıca doğrulayın. Eğitim verilerindeki önyargılar arama sonuçlarına yansıyabileceğinden, özellikle insan görselleriyle çalışıyorsanız sonuçları denetleyin ve ticari kullanım koşullarını hukuk biriminizle değerlendirin.
Müşterinin yüklediği fotoğrafları saklamalı mıyım?
Saklamak zorunda değilsiniz ve çoğu durumda saklamamak daha güvenlidir. Sorgu görselini bellekte işleyip embedding ürettikten sonra silebilirsiniz. İyileştirme amacıyla saklayacaksanız kullanıcıyı aydınlatın ve saklama süresi belirleyin, çünkü fotoğraflar kişisel veri içerebilir. Görsellerin boyutunu ve türünü sunucuda sınırlamak, kötü amaçlı dosyalara karşı da koruma sağlar.
Görsel arama sonucu nasıl iyileştirilir?
İlk adım görsel ön işlemedir: Arka planı temizlemek ve ürünü kırpmak benzerliği belirgin biçimde artırabilir. Ardından görsel skoru metin, kategori ve popülerlik gibi sinyallerle birleştirin. Kendi ürünlerinizde sonuç yetersizse modeli ince ayarlamayı düşünün. Değişikliklerin etkisini ilk 10 sonuçtaki doğru ürün oranı gibi ölçülebilir bir metrikle takip edin.
Sistem aynı anda kaç sorguya yanıt verir?
Yanıt sayısı model boyutuna, batch stratejisine, paylaşımlı kartın o anki yüküne ve indeks tipine bağlıdır, bu yüzden genel bir rakam vermek yanıltıcı olur. Kendi trafiğinize benzer bir yük testi yapın, yanıt süresini yüksek yüzdelik değerlerle ölçün. Gelen sorguları kısa aralıklarla gruplayıp tek batch halinde kodlamak kartı çok daha verimli kullanır.
Sonuç: E-Ticaret Görsel Arama Yapay Zeka Altyapısı Kararı
E-ticaret görsel arama yapay zeka altyapısında önce kataloğunuzun vektör belleğini hesaplayın, ardından paketi RAM ve VRAM birlikte düşünerek seçin. CLIP ViT-B/32 ile başlayın, ANN aramasını işlemcide tutun, büyük ilk indekslemeyi ve model ince ayarını fiziksel sunucuya bırakın.
Yıllık alımlarda 10 ay öde, 12 ay kullan kampanyasından yararlanabilirsiniz. Ürün sayınızı ve arama trafiğinizi WhatsApp canlı destekten iletin; 7/24 Türkçe destek ekibimiz paket seçimi ve kurulum konusunda sipariş öncesinde size yardımcı olur.
GPU VDS
Kataloğunuz için doğru paketi birlikte seçelim
Ürün sayınızı ve günlük arama trafiğinizi canlı destekle paylaşın; VRAM ve RAM ihtiyacınızı sipariş öncesinde birlikte hesaplayalım.
Önem Bilişim Teknik Ekibi
2019’dan beri hizmet veren, ETBİS kayıtlı bir sunucu ve yazılım hizmetleri şirketiyiz. GPU VDS, fiziksel sunucu ve barındırma hizmetlerimizde 7/24 Türkçe teknik destek sunuyoruz.
Son güncelleme: 9 Kasım 2026